Push 163 file(s) from Obsidian
This commit is contained in:

@@ -0,0 +1,178 @@
|
||||
---
|
||||
title: 10 продвинутых советов по Git
|
||||
source: https://nuancesprog.ru/p/24223/
|
||||
author:
|
||||
published: 2025-05-27
|
||||
created: 2025-08-24
|
||||
description: Git — один из самых широко применяемых инструментов совместной работы при разработке ПО. Даже разработчики программного обеспечения, работающие в одиночку, часто используют Git как систему контроля версий. Большинство людей работают с Git через командную строку, но многие редакторы кода и IDE имеют интеграцию Git со встроенными инструментами, упрощающими рабочий процесс. Git используется широко, но многие разработчики имеют лишь поверхностное представление обо всем, что он может предложить. Сегодня делимся некоторыми секретами инструмента.
|
||||
tags:
|
||||
- clippings
|
||||
- "#git"
|
||||
---
|
||||
Git — один из самых широко применяемых инструментов совместной работы при разработке ПО. Даже разработчики программного обеспечения, работающие в одиночку, часто используют Git как систему контроля версий. Большинство людей работают с Git через командную строку, но многие редакторы кода и IDE имеют интеграцию Git со встроенными инструментами, упрощающими рабочий процесс. Git используется широко, но многие разработчики имеют лишь поверхностное представление обо всем, что он может предложить. Сегодня делимся некоторыми секретами инструмента.
|
||||
|
||||
Поскольку вы здесь, то, наверное, вы готовы выйти за рамки простого (но полноценного!) рабочего процесса:
|
||||
|
||||
```nginx
|
||||
git add .
|
||||
git commit -m "fix"
|
||||
git push
|
||||
```
|
||||
|
||||
Надеюсь, эти советы и рекомендации по Git повысят вашу эффективность и продуктивность. Если вы станете лучше применять инструменты, которые вам приходится использовать так же часто, как и Git, то вы сможете тратить больше времени на программирование. Разве не здорово тратить меньше времени в попытках решить, использовать `git merge` или `git rebase`?
|
||||
|
||||
## 10\. Пустые коммиты
|
||||
|
||||
Вы когда-нибудь вносили небольшие изменения в README, чтобы можно было запустить сборку CI (или какую-нибудь другую интеграцию) и попытаться отладить какую-то проблему? Раньше я делала это довольно часто, пока не узнала о следующей полезной команде:
|
||||
|
||||
```nginx
|
||||
git commit --allow empty -m 'it works!'
|
||||
```
|
||||
|
||||
Этот флаг git позволяет инициировать коммит без содержимого и миновать обычную ошибку, говорящую, что у вас нет подготовленных файлов. Этот прием особенно полезен для того, чтобы запустить рабочий процесс без мелких изменений в README или какого-нибудь другого файла. Команда `git diff` не покажет никаких изменений, но коммит полезен, когда нужно запустить CI-прогон или даже развертывание в продакшне, а отправлять какой-то произвольный код не нужно.
|
||||
|
||||
## 9\. Приятный лог
|
||||
|
||||
Команда `git log` — очень полезный способ просмотреть последние изменения кодовой базы, но глаза быстро разбегаются, если запускать ее в проекте с большим количеством веток. Еще одна хитрость git — сделать `git log` интереснее, добавив немного цвета, чтобы помочь глазам и мозгу лучше читать вывод на экране.
|
||||
|
||||
Чтобы получить улучшенный вывод `git log`, не меняя конфигурацию Git, просто запустите эту команду:
|
||||
|
||||
```sql
|
||||
git log --pretty=oneline --graph --decorate --all</span >
|
||||
```
|
||||
|
||||
Вот пример того, что можно ожидать:
|
||||
|
||||
Вы заметите как цветовое кодирование, так и разумное применение `|` и `\\`, чтобы обозначить ветки. Хотя эти флаги ничего не меняют в логе функционально, они, безусловно, значительно облегчают понимание вывода `git log`.
|
||||
|
||||
## 8\. Очистка локальных веток
|
||||
|
||||
Если вы похожи на меня, то вам нравится поддерживать относительный порядок на рабочем месте, в том числе на компьютере.
|
||||
|
||||
Разработка ПО способна быстро привести к замешательству, особенно если вы работаете с большим количеством репозиториев. Ситуацию усугубляет работа с Git, который в каждом репозитории может оставить несколько ветвей на долгое время уже после того, когда эти ветки не нужны.
|
||||
|
||||
Наверное, со временем вы добавили в конфигурацию Git разные вещи, чтобы изменить свои ощущения от работы. А мне очень понравился параметр `git config`, при выполнении `fetch` или `pull` удаляющий любую локальную ветку, которая удалена из репозитория на сервере.
|
||||
|
||||
Быстро установить этот параметр можно, выполнив:
|
||||
|
||||
```nginx
|
||||
git config --global fetch.prune true
|
||||
```
|
||||
|
||||
Еще один совет по Git, кроме изменения конфигурации, — пойти дальше и удалить локальные ветки, которые уже влиты в `master`.
|
||||
|
||||
Выполните эту команду:
|
||||
|
||||
```nginx
|
||||
git branch --merged master | grep -v "master" | xargs -n 1 git branch -d
|
||||
```
|
||||
|
||||
## 7\. Поиск убранного коммита через git reflog
|
||||
|
||||
Выполнять `git rebase` крайне полезно, особенно с флагом `--interactive`. Однако перебазирование может быть опасно. При локальном `git rebase` вам придется принудительно перезаписать изменения в репозитории на сервере. Выполняя перебазирование достаточно часто, вы в конечном счете случайно удалите коммит или несколько.
|
||||
|
||||
Если вам не повезло так же, как и мне, или вы не информированы, то можете даже случайно удалить работу, выполненную за неделю. Один из моих любимых советов — выполните `git reflog`, чтобы вернуть недостающие коммиты из мертвых.
|
||||
|
||||
Поскольку вы закоммитили свою работу, она все еще находится в вашей локальной рабочей копии репозитория вне зависимости от того, делали ли вы `git rebase`. С помощью `git reflog` можно найти хеш SHA1, который вам нужен. Затем запустите `git checkout <SHA1>`, скопируйте все, что вам нужно, и запустите `git checkout HEAD`, чтобы вернуться к самому последнему коммиту в локальной ветке. И кризис предотвращен!
|
||||
|
||||
## 6\. Алиас для git blame
|
||||
|
||||
Время от времени возникает ошибка, которую вы не сможете обнаружить самостоятельно. А иногда захочется или будет нужно обратиться к человеку, который, похоже, написал неработающий код. Возможно, вам даже захочется поговорить с автором, чтобы лучше понять контекст кода.
|
||||
|
||||
Чтобы выяснить, кто написал строку кода, часто используют `git blame`. Команда `git blame` показывает, кто на самом деле написал строку кода, когда написал ее и в каком коммите она добавлена в кодовую базу. Эта функциональность встроена во многие редакторы кода и IDE — имена отображаются рядом с каждой строкой кода!
|
||||
|
||||
Это недооцененная функция Git, но запускать `git blame` не очень приятно. Важно, чтобы команды разработчиков ПО формировали культуру без обвинений, а формулировка `git blame` может создать неподходящий прецедент.
|
||||
|
||||
И вот хорошая новость! На самом деле вы можете переименовать команду, используя алиас из вашей конфигурации Git. Это самый подвижнический из советов здесь. Чтобы создать псевдоним `git balme`, который будет вызываться как `git investigate`, выполните команду:
|
||||
|
||||
```cs
|
||||
git config --global alias.investigate blame
|
||||
```
|
||||
|
||||
`investigate` можно заменить на любое слово! Ваша конфигурация Git также может содержать псевдонимы для других команд, а не только `git blame`, если захотите.
|
||||
|
||||
## 5\. Команда git add -p для поэтапного коммита
|
||||
|
||||
В начале статьи я обещала, что мы оставим `git add` в прошлом. Наверное, вы уже знаете, что все изменения можно в локальном репозитории можно подготовить к коммиту через `git add`.
|
||||
|
||||
И, вероятно, *еще* вы знаете, что это делается более многословно. С просмотром того, какие изменены файлы, через `git status` и с проверкой изменения файла с помощью `git diff <filename>`, а также с подготовкой файлов по отдельности с помощью `git add <filename>`. Нормально, если вы готовите к коммиту один файл, но это может быстро стать проблемой, когда у вас большой набор локальных изменений.
|
||||
|
||||
Эта опция многословнее, но это важный шаг, чтобы проверить, что вы подготовили локальные изменения, которые собираетесь закоммитить. Нет ничего хуже, чем закоммитить что-нибудь случайно, особенно если код содержит конфиденциальные данные, например секрет приложения. К счастью, есть способ внести изменения еще лучше!
|
||||
|
||||
Вносить изменения можно *по кусочку*, выполнив:
|
||||
|
||||
```nginx
|
||||
git add -p
|
||||
```
|
||||
|
||||
Вероятно, этот совет сильнее всего ускорит вашу работу. При такой подготовке коммитов в Git открывается интерактивная подсказка. Она показывает разделы каждого файла, которые были изменены. Это дает возможности подготовить их к коммиту или пропустить и многие другие возможности.
|
||||
|
||||
Команда упрощает поэтапную обработку изменений валидацией каждого изменения, а еще она полезна, если вы хотите закоммитить только часть изменений файла. Иногда я увлекаюсь до степени понимания того, что изменений у меня в файле гораздо больше, чем имеет смысл коммитить вместе.
|
||||
|
||||
Вот пример:
|
||||
|
||||
## 4\. Кусочки кода в git stash
|
||||
|
||||
Флаг `-p` предназначен не только для подготовки кода! Его можно использовать с `git stash`, если не хочется выполнять `git stash` *на всех файлах* или на одном файле с изменениями целиком.
|
||||
|
||||
Чтобы поэтапно выполнить `git stash` для кода в рабочем каталоге, выполните:
|
||||
|
||||
```nginx
|
||||
git stash -p
|
||||
```
|
||||
|
||||
При запуске вы увидите интерактивный экран, аналогичный экрану команды `git add -p`, который шаг за шагом проведет вас через каждое изменение по одному разделу за раз.
|
||||
|
||||
## 3\. Автоматизация git bisect
|
||||
|
||||
Хотя это самый сложный из приемов Git, автоматизация `git bisect` со временем может принести пользу. Если вы уже понимаете, [как использовать git bisect](https://www.metaltoad.com/blog/beginners-guide-git-bisect-process-elimination), то знаете, что работа с `git bisect` может потребовать большого количества команд. А это, в свою очередь, может сделать ее не такой практичной.
|
||||
|
||||
Она сложная, поэтому вам может быть интересно узнать, что на самом деле можно написать скрипт, который автоматизирует часть процесса. [Написав скрипт git bisect](https://git-scm.com/docs/git-bisect#_bisect_run), для запуска скрипта вы сможете использовать простую команду:
|
||||
|
||||
`git bisect run my_script аргументы`
|
||||
|
||||
## 2\. Эмоджи в Git
|
||||
|
||||
Хотя это, наверное, самый бесполезный из этих советов этой статьи, эмоджи в сообщениях о коммитах — простой способ добавить веселья вам и вашим коллегам! Можно легко вставлять смайлы в сообщения о коммитах, если знаете их названия. Воспользуйтесь шпаргалкой [Gitmoji](https://gitmoji.dev/), чтобы выбрать подходящий смайлик и вставить его в виде текста в сообщение о коммите:
|
||||
|
||||
```nginx
|
||||
git commit -m ":package: Add a docker container to the app"
|
||||
```
|
||||
|
||||
## 1\. Справочная документация Git
|
||||
|
||||
Меня всегда удивляет, как быстро я забываю о встроенных справочных инструментах в ряде приложений и интерфейсах командной строки. Я буду пытаться найти ответ в бесконечном количестве ответов на Stack Overflow, чтобы решить свою проблему.
|
||||
|
||||
И, наконец, вспомню, что могу получить помощь, просто запустив:
|
||||
|
||||
```nginx
|
||||
git help
|
||||
```
|
||||
|
||||
Вся документация Git у вас под рукой как часть интерфейса командной строки Git! Если вы новичок в Git или просто хотите освежить знания, то командой ниже можете даже перейти к руководству:
|
||||
|
||||
```nginx
|
||||
git help tutorial
|
||||
```
|
||||
|
||||
В этом руководстве вы познакомитесь с основами.
|
||||
|
||||
Наконец, если вы хотите получить документацию по конкретной команде, то можете использовать `man`, чтобы получить мануал. Например, выполните `man git-log`, если хотите больше узнать о команде `git log`.
|
||||
|
||||
## Еще больше советов по Git
|
||||
|
||||
Вот и мои десять любимых советов и приемов с Git. Будь то настройка конфигурации, подготовка изменений через `git add -p`, `-p` с `git stash` или `git reflog`, эти трюки сделают Git полезнее для вас и вашей команды. Надеюсь, вы наткнулись на что-нибудь новое или освежили память о команде, которую забыли.
|
||||
|
||||
Git — удивительно мощный инструмент, и мы должны использовать его по максимуму. Если вы нашли какой-то трюк с Git полезным, поделитесь им со своими коллегами!
|
||||
|
||||
Читайте также:
|
||||
|
||||
- [Git: простое руководство о том, как стать мастером контроля версий](https://nuancesprog.ru/p/16934/)
|
||||
- [Руководство по Git для новичков](https://nuancesprog.ru/p/21021/)
|
||||
- [7 полезных репозиториев GitHub для JS-программистов](https://nuancesprog.ru/p/17131/)
|
||||
|
||||
Читайте нас в [Telegram](https://t.me/nuancesprog), [VK](https://vk.com/nuancesprog) и [Дзен](https://dzen.ru/nuancesprog.ru)
|
||||
|
||||
---
|
||||
|
||||
*Перевод статьи* [Julie Kent](https://nuancesprog.ru/p/24223/%D1%81%D1%81%D1%8B%D0%BB%D0%BA%D0%B0_%D0%BD%D0%B0_%D0%B0%D0%B2%D1%82%D0%BE%D1%80%D0%B0):
|
||||
@@ -0,0 +1,372 @@
|
||||
---
|
||||
title: Linux Bash Справочник
|
||||
source: https://www.glukhov.org/ru/post/2024/04/bash-cheat-sheet/
|
||||
author:
|
||||
- "[[Рост Глухов | Персональный сайт и технический блог]]"
|
||||
published: 2024-04-18
|
||||
created: 2025-08-23
|
||||
description: "Bash: Справочник"
|
||||
tags:
|
||||
- clippings
|
||||
- "#linux"
|
||||
- "#bash"
|
||||
---
|
||||
Не очень подробный список, просто несколько полезных для меня пунктов
|
||||
|
||||
|
||||
|
||||
## Проверка версии Linux Ubuntu
|
||||
|
||||
Метод 1
|
||||
|
||||
```bash
|
||||
lsb_release -a
|
||||
```
|
||||
|
||||
выдаст что-то вроде
|
||||
|
||||
```bash
|
||||
Нет доступных модулей LSB.
|
||||
Идентификатор дистрибутива: Linuxmint
|
||||
Описание: Linux Mint 22.1
|
||||
Версия: 22.1
|
||||
Кодовое имя: xia
|
||||
```
|
||||
|
||||
Метод 2
|
||||
|
||||
```bash
|
||||
cat /etc/os-release
|
||||
```
|
||||
|
||||
выдаст что-то вроде
|
||||
|
||||
```bash
|
||||
NAME="Linux Mint"
|
||||
VERSION="22.1 (Xia)"
|
||||
ID=linuxmint
|
||||
ID_LIKE="ubuntu debian"
|
||||
PRETTY_NAME="Linux Mint 22.1"
|
||||
VERSION_ID="22.1"
|
||||
HOME_URL="https://www.linuxmint.com/"
|
||||
SUPPORT_URL="https://forums.linuxmint.com/"
|
||||
BUG_REPORT_URL="http://linuxmint-troubleshooting-guide.readthedocs.io/en/latest/"
|
||||
PRIVACY_POLICY_URL="https://www.linuxmint.com/"
|
||||
VERSION_CODENAME=xia
|
||||
UBUNTU_CODENAME=noble
|
||||
```
|
||||
|
||||
## Архивирование и распаковка
|
||||
|
||||
Сжатие
|
||||
|
||||
```bash
|
||||
tar -zcvf archive-name.tgz directory-name
|
||||
```
|
||||
|
||||
Распаковка
|
||||
|
||||
```bash
|
||||
tar -zxvf archive-name.tgz
|
||||
```
|
||||
|
||||
## Удалённые серверы
|
||||
|
||||
Передача идентификатора пользователя на удалённый сервер
|
||||
|
||||
```bash
|
||||
ssh-copy-id user@10.0.0.225
|
||||
```
|
||||
|
||||
Это позволит войти без пароля в следующий раз, например:
|
||||
|
||||
```bash
|
||||
ssh user@10.0.0.225
|
||||
```
|
||||
|
||||
Загрузка файла
|
||||
|
||||
```bash
|
||||
scp ~/file.ext user@host-ip:/home/user/file.ext
|
||||
```
|
||||
|
||||
Загрузка папки с вложенными элементами рекурсивно
|
||||
|
||||
```bash
|
||||
scp -r user@host-ip:/home/user/dir ~/dir
|
||||
```
|
||||
|
||||
## Папки и файлы
|
||||
|
||||
Проверка на существование
|
||||
|
||||
```bash
|
||||
# создать папку, если она не существует, со всеми промежуточными папками
|
||||
[ -d $repdir ] || mkdir -p $repdir
|
||||
|
||||
# или
|
||||
if [ -d $fname ]; then
|
||||
echo "Файл не существует: $fname"
|
||||
return
|
||||
fi
|
||||
```
|
||||
|
||||
Создание папки для определённого пользователя
|
||||
|
||||
```bash
|
||||
sudo mkdir dir1
|
||||
sudo chown specific_user dir1
|
||||
sudo chown :specific_group dir1
|
||||
```
|
||||
|
||||
Итерация по файлам в папке
|
||||
|
||||
```bash
|
||||
# этот пример конвертирует все jpg файлы в некоторой папке в fits
|
||||
for f in some-folder/*.jpg
|
||||
do
|
||||
convert "$f" "${f/.jpg/.fits}"
|
||||
done
|
||||
```
|
||||
|
||||
Объединение всех файлов в один
|
||||
|
||||
```bash
|
||||
cat ./* > merged.txt
|
||||
```
|
||||
|
||||
## Добавление выполнения команды в crontab
|
||||
|
||||
```bash
|
||||
(crontab -l 2>/dev/null | \
|
||||
grep -v control-marker-1; \
|
||||
echo '*/15 * * * * /bin/bash /home/user/stest/stest.sh /home/user/stest >> /home/user/stest/stest.log 2>&1 #control-marker-1') | \
|
||||
crontab -
|
||||
```
|
||||
|
||||
здесь:
|
||||
|
||||
- \*/15 - выполняется каждые 15 минут
|
||||
- control-marker-1 - идентификатор этой команды в конфигурации cron для обновления её в следующий раз с тем же скриптом
|
||||
- /bin/bash - команда для выполнения
|
||||
- /home/user/stest/stest.sh - параметр bash - bash выполнит этот скрипт
|
||||
- /home/user/stest - параметр скрипта - будет доступен как $1
|
||||
- /home/user/stest/stest.log - файл журнала с выводом консоли stest.sh
|
||||
|
||||
Проверка
|
||||
|
||||
```bash
|
||||
grep /home/user/stest/stest.sh /var/log/syslog
|
||||
crontab -e
|
||||
```
|
||||
|
||||
## Журналы
|
||||
|
||||
Просмотр журнала в режиме реального времени
|
||||
|
||||
```bash
|
||||
sudo tail -f /var/log/megalog.log
|
||||
```
|
||||
|
||||
## Код состояния curl
|
||||
|
||||
```bash
|
||||
response=$(curl --write-out '%{http_code}' --silent --output /dev/null servername)
|
||||
|
||||
# или
|
||||
|
||||
url='http://localhost:8080/'
|
||||
status=$(curl --head --location --connect-timeout 5 --write-out %{http_code} --silent --output /dev/null ${url})
|
||||
|
||||
[[ $status == 500 ]] || [[ $status == 000 ]] && echo restarting ${url} # выполнить логику запуска/перезапуска
|
||||
```
|
||||
|
||||
## Оставить команду ssh работающей после выхода
|
||||
|
||||
[https://stackoverflow.com/questions/954302/how-to-make-a-program-continue-to-run-after-log-out-from-ssh](https://stackoverflow.com/questions/954302/how-to-make-a-program-continue-to-run-after-log-out-from-ssh)
|
||||
|
||||
Предположим, у вас запущена программа в переднем плане, нажмите
|
||||
|
||||
- ctrl-Z, затем:
|
||||
|
||||
\[1\]+ Остановлено myprogram
|
||||
|
||||
- disown -h %1
|
||||
- bg 1
|
||||
|
||||
\[1\]+ myprogram &
|
||||
|
||||
- logout
|
||||
|
||||
## Генерация JSON
|
||||
|
||||
Установите jo
|
||||
|
||||
```bash
|
||||
sudo apt-get install jo
|
||||
```
|
||||
```bash
|
||||
a="123"
|
||||
b="45语
|
||||
jo "model=a" "prompt=b" "stream=false"
|
||||
```
|
||||
|
||||
выдаст
|
||||
|
||||
```bash
|
||||
{"model":"a", "prompt":"b", "stream":false}
|
||||
```
|
||||
|
||||
Сlightly более сложный пример:
|
||||
|
||||
```bash
|
||||
jo -p name=Jane point[]=1 point[]=2 geo[lat]=10 geo[lon]=20
|
||||
{
|
||||
"name": "Jane",
|
||||
"point": [
|
||||
1,
|
||||
2
|
||||
],
|
||||
"geo": {
|
||||
"lat": 10,
|
||||
"lon": 20
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
## Форматирование JSON
|
||||
|
||||
Используйте
|
||||
|
||||
```bash
|
||||
| jq .
|
||||
```
|
||||
|
||||
Для форматирования JSON, созданного выше:
|
||||
|
||||
```bash
|
||||
a="123"
|
||||
b="456"
|
||||
jo "model=$a" "prompt=$b" "stream=false" | jq .
|
||||
```
|
||||
|
||||
Форматированный JSON будет:
|
||||
|
||||
```bash
|
||||
{
|
||||
"model": 123,
|
||||
"prompt": 456,
|
||||
"stream": false
|
||||
}
|
||||
```
|
||||
|
||||
## Парсинг JSON и возврат значения определённого поля
|
||||
|
||||
Сначала установите jq
|
||||
|
||||
```bash
|
||||
sudo apt-get install jq
|
||||
```
|
||||
|
||||
Используйте
|
||||
|
||||
```bash
|
||||
| jq -r '.fieldName'
|
||||
```
|
||||
|
||||
Например, парсинг вывода вызова Ollama:
|
||||
|
||||
```bash
|
||||
curl http://localhost:11434/api/generate -d '{
|
||||
"model": "llama3",
|
||||
"prompt": "Why is the sky blue?",
|
||||
"stream": false
|
||||
}' | jq -r '.response'
|
||||
```
|
||||
|
||||
## Подсчёт слов в файле
|
||||
|
||||
Подсчёт слов:
|
||||
|
||||
```bash
|
||||
wc -w filename.txt
|
||||
```
|
||||
|
||||
вернёт что-то вроде
|
||||
|
||||
```bash
|
||||
261 filename.txt
|
||||
```
|
||||
|
||||
Если вы хотите просто число, вы можете вырезать первое слово, которое является числом
|
||||
|
||||
```bash
|
||||
words=\`wc -w filename.txt | cut -f1 -d' '\`
|
||||
echo "$words слов"
|
||||
```
|
||||
|
||||
Или используйте wc так:
|
||||
|
||||
```bash
|
||||
words=\`wc -w < filename.txt\`
|
||||
echo "$words слов"
|
||||
```
|
||||
|
||||
## Проверка, сколько места занимает директория на HDD
|
||||
|
||||
```bash
|
||||
du ~/dirname
|
||||
```
|
||||
|
||||
## Получение имени папки, в которой находится выполняемый скрипт
|
||||
|
||||
```bash
|
||||
SCRIPT_DIR=$( cd -- "$( dirname -- "${BASH_SOURCE[0]}" )" &> /dev/null && pwd )
|
||||
```
|
||||
|
||||
## Измерение времени выполнения скрипта
|
||||
|
||||
Один из вариантов - использовать функцию time
|
||||
|
||||
```bash
|
||||
time your_script.sh
|
||||
```
|
||||
|
||||
Другой способ немного сложнее:
|
||||
|
||||
```bash
|
||||
start=\`date +%s\`
|
||||
|
||||
# очень важный код
|
||||
# здесь
|
||||
|
||||
end=\`date +%s\`
|
||||
|
||||
runtime=$((end-start))
|
||||
```
|
||||
|
||||
## Сравнение двух файлов с помощью VS Code
|
||||
|
||||
```bash
|
||||
code -d <файл 1> <файл 2>
|
||||
```
|
||||
|
||||
## Проверка доступных пакетов в репозитории Ubuntu
|
||||
|
||||
```bash
|
||||
sudo apt-cache policy <packageName>
|
||||
```
|
||||
|
||||
## Полезные ссылки
|
||||
|
||||
- [Справочник по Python](https://www.glukhov.org/ru/post/2024/08/python-cheat-sheet/)
|
||||
- [Справочник по Conda](https://www.glukhov.org/ru/post/2024/10/conda-cheatsheet/ "Справочник по Conda")
|
||||
- [Синхронизация закладок с Floccus](https://www.glukhov.org/ru/post/2024/08/sync-bookmarks-floccus/)
|
||||
- [Переустановка Linux](https://www.glukhov.org/ru/post/2024/04/reinstall-linux/)
|
||||
- [Справочник по Ollama](https://www.glukhov.org/ru/post/2024/12/ollama-cheatsheet/ "Справочник по Ollama")
|
||||
- [Справочник по Docker](https://www.glukhov.org/ru/post/2024/10/docker-cheatsheet/ "список и описание наиболее часто используемых и полезных команд Docker - справочник по Docker")
|
||||
- [Справочник по Kubernetes](https://www.glukhov.org/ru/post/2024/10/kubernetes-cheatsheet/ "список и описание наиболее часто используемых и полезных команд k8s - справочник по k8s")
|
||||
- [Справочник по Markdown](https://www.glukhov.org/ru/post/2024/03/markdown-cheatsheet/ "Полный справочник по Markdown")
|
||||
- [Кодирование и декодирование Base64 в Windows, Linux и Mac](https://www.glukhov.org/ru/post/2025/04/base64/ "Справочник по кодированию/декодированию Base64 в Linux, Windows и Mac")
|
||||
- [Декодирование и вывод JWT токена](https://www.glukhov.org/ru/post/2025/04/decode-and-print-jwt-token/ "Как декодировать и вывести полезную нагрузку JWT токена в Linux bash")
|
||||
- [Параметры командной строки MinIO](https://www.glukhov.org/ru/post/2025/05/minio-cheatsheet/ "Справочник по параметрам командной строки MinIO")
|
||||
@@ -0,0 +1,341 @@
|
||||
---
|
||||
title: "XML-формат: что это такое и как открыть файл — журнал «Код»"
|
||||
source: https://thecode.media/chto-takoe-xml/
|
||||
author:
|
||||
published: 2025-06-30
|
||||
created: 2025-08-24
|
||||
description: Рассказываем и показываем на примерах, что такое XML-формат файлов, как он устроен и где применяется.
|
||||
tags:
|
||||
- clippings
|
||||
- "#XML"
|
||||
---
|
||||
Когда мы говорили [о разметке в Маркдауне](https://thecode.media/markdown/), то там смысл был такой: есть текст, а мы его размечаем специальными символами, чтобы он хорошо выглядел. Теперь перейдём на этап выше — будем форматировать данные на уровне логики с помощью XML.
|
||||
|
||||
👉 XML нужен для работы с техническим текстом, где всё строго, упорядоченно и логично. Его, конечно, можно применить и к художественному тексту, но выйдет так себе.
|
||||
|
||||
## Что такое XML-формат
|
||||
|
||||
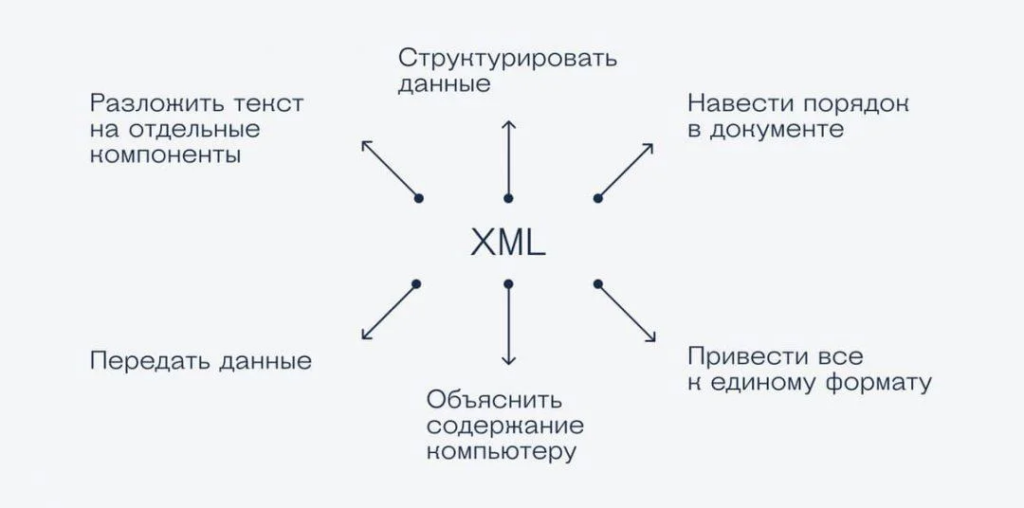
XML — это сокращение от eXtensible Markup Language, а переводится это как «расширяемый язык разметки». Смысл XML в том, чтобы выстроить внутри документа логическую структуру — чтобы было видно, что к чему относится и как всё связано между собой, в каком формате представлены данные.
|
||||
|
||||
### Зачем нужен
|
||||
|
||||
С помощью XML можно:
|
||||
|
||||
- записать оргструктуру компании или любую другую иерархию — «этот подчиняется тому»;
|
||||
- разметить текст по смыслу — «тут важное, там второстепенное, вот это поясняет вон то»;
|
||||
- хранить типовые данные — например, имена артистов, названия их альбомов и треки, или настройку какой-нибудь программы, или скрипты;
|
||||
- разметить веб-страницу по смыслу и отдать эту разметку алгоритму, который сам нарисует дизайн;
|
||||
- разметить текст для дальнейшего машинного обучения;
|
||||
- хранить результаты работы программ, которые работают с текстом, — например, ничто не мешает текстовым редакторам хранить документы со всем оформлением в формате XML.
|
||||
|
||||
И многое другое, где нужен порядок, структура и работа с текстовыми данными.
|
||||
|
||||
|
||||
|
||||
Что такое XML-формат и для чего он нужен
|
||||
|
||||
## В чём сила XML
|
||||
|
||||
Сила XML в том, что данные здесь представляются как обычный текст, размеченный тегами (как в HTML). Например, чтобы записать оргструктуру компании в XML, не нужно рисовать схему в графическом редакторе, достаточно правильно разметить текст с именами и должностями. Файлики получаются маленькими, их легко обрабатывать.
|
||||
|
||||
[База по вёрстке: основы HTML](https://thecode.media/baza-po-vyorstke-osnovy-html/)
|
||||
|
||||
И ещё сила XML в том, что эти данные может прочитать и обработать компьютер. Например, если мы передаём ему оргструктуру компании, компьютер поймёт её: кто кому подчиняется, что куда входит и т. д. Для сравнения: если скормить компьютеру схему, нарисованную в графическом редакторе, он её не поймёт.
|
||||
|
||||
А вот если XML хорошо составлен, его также может понять человек.
|
||||
|
||||
Вам может быть интересно:
|
||||
|
||||
[ Markdown: что это и кому нужно](https://thecode.media/markdown/)
|
||||
|
||||
## Из чего состоит XML
|
||||
|
||||
Внешне XML очень похож на HTML: в нём тоже всё пишется в угловых скобках, есть закрывающие теги и параметры — аналоги классов и стилей. Но, в отличие от HTML, здесь нет обязательных тегов или вообще каких-то обязательных элементов. Объясним, как это работает, на примере.
|
||||
|
||||
[Самые частые ошибки в HTML-вёрстке](https://thecode.media/samye-chastye-oshibki-v-html-vyorstke/)
|
||||
|
||||
Допустим, у нас есть такой текст, из которого нужно сделать XML-документ:
|
||||
|
||||
*«По состоянию на 22 мая 2025 журнал „Код“ работает и в редакции есть главред Михаил Полянин и авторы Кристина Тульцева и Игорь Росляков».*
|
||||
|
||||
### Теги и атрибуты
|
||||
|
||||
Основное тело XML-документа состоит из тегов и атрибутов.
|
||||
|
||||
Теги образуют всю структуру файла. Если вы немного знакомы с HTML, то увидите, что здесь они выглядят так же. В основном теги бывают открывающие (`<tag>`) и закрывающие (`</tag>`). Но, в отличие от HTML, в XML можно использовать любые теги, которые нужны по логике создания файла.
|
||||
|
||||
Атрибуты — это дополнительные параметры тега, которые записываются внутри открывающего тега. Они заключены в кавычки. Может выглядеть так:
|
||||
|
||||
```markup
|
||||
<tag attr="value">
|
||||
```
|
||||
|
||||
### Комментарии и специальные символы
|
||||
|
||||
Комментарии в XML такие же, как в HTML. Это текстовые пометки, которые не влияют на остальной файл:
|
||||
|
||||
```markup
|
||||
<!-- это комментарий, он не влияет на файл -->
|
||||
```
|
||||
|
||||
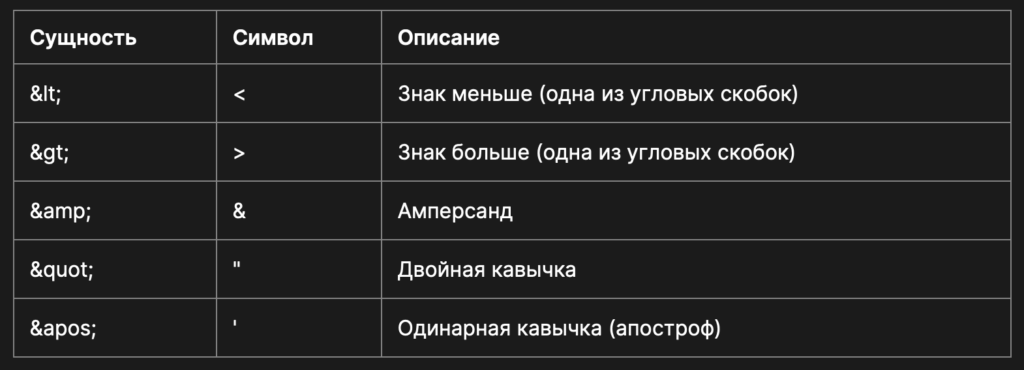
Спецсимволы — это символы вроде угловых обозначений тегов. Мы не можем их использовать между настоящими тегами в чистом виде, потому что тогда файл сломается: он подумает, что мы открываем новый тег или делаем ещё какое-то действие, а нам на самом деле нужно просто поставить символ в текст.
|
||||
|
||||
[Что такое формат JSON и как с ним работать](https://thecode.media/json/)
|
||||
|
||||
Для работы со спецсимволами нужно использовать соответствующие им наборы других символов, которые ещё называются сущности. Если мы поставим в текст сущности, машина на выходе выведет как раз тот спецсимвол, который нам нужен.
|
||||
|
||||
Например, амперсанд `&` относится к числу спецсимволов, поэтому нельзя сделать так:
|
||||
|
||||
```markup
|
||||
<title> Sanford&Son</title>
|
||||
```
|
||||
|
||||
Вместо этого нужно так:
|
||||
|
||||
```markup
|
||||
<title> Sanford&Son</title>
|
||||
```
|
||||
|
||||
Длиннее, зато работает.
|
||||
|
||||
Вот основные спецсимволы и соответствующие им сущности:
|
||||
|
||||
|
||||
|
||||
Источник: developer.mozilla.org
|
||||
|
||||
### Пролог
|
||||
|
||||
Любой XML начинается с пролога, это первая строка документа. В ней нужно написать, что перед нами именно XML:
|
||||
|
||||
```markup
|
||||
<?xml version="1.0" encoding="UTF-8"?>
|
||||
```
|
||||
|
||||
Пролог говорит, что ниже будет XML-разметка. Иначе программа-обработчик не будет знать, что с ним делать — рисовать как HTML или выводить как просто текст?
|
||||
|
||||
[Делаем сами себе игру для Android](https://thecode.media/stack-game-3/)
|
||||
|
||||
Что есть в прологе:
|
||||
|
||||
- Версия XML. Обычно 1.0.
|
||||
- Кодировка для корректной работы с символами текста. В нашем примере это UTF-8.
|
||||
|
||||
### Корневой элемент
|
||||
|
||||
Внутри XML-документа всегда есть корневой тег-элемент — внутри него лежит всё остальное. Так как в XML мы придумываем названия для разметки сами, то пусть этот элемент будет называться `actual` (это название может быть любым):
|
||||
|
||||
```markdown
|
||||
<?xml version="1.0" encoding="UTF-8"?>
|
||||
<actual>
|
||||
<!-- содержимое корневого элемента -->
|
||||
</actual>
|
||||
```
|
||||
|
||||
### Содержимое внутри корневого элемента
|
||||
|
||||
Теперь разбираем содержимое. Первое, что мы видим в документе, — это дата, поэтому можем сделать отдельный раздел со статусом издания. В него будет входить значение `Active` (издание работает) и два параметра — дата последней проверки и статус этой проверки. Сам элемент мы назовём `status`:
|
||||
|
||||
```markdown
|
||||
<?xml version="1.0" encoding="UTF-8"?>
|
||||
<actual>
|
||||
<!-- содержимое корневого элемента -->
|
||||
<status lastUpd = "22.05.2025" checked = "true">
|
||||
Active
|
||||
</status>
|
||||
</actual>
|
||||
```
|
||||
|
||||
Это очень похоже на стили и классы в HTML, но работает иначе: мы просто указываем параметры и их значения, а не подключаем какие-то внешние данные или правила.
|
||||
|
||||
Ещё вы могли заметить, что мы пишем дату в нестандартном формате (с точки зрения компьютера). Так можно: если мы потом будем писать обработчик этого XML, мы сможем научить его читать именно этот формат даты.
|
||||
|
||||
[Почему программистам сложно работать со временем в программах](https://thecode.media/timezone/)
|
||||
|
||||
👉 Это история о том, что XML — это просто полочки, на которые мы раскладываем данные. Какие там данные — ему не важно.
|
||||
|
||||
Добавим ниже сведения про название журнала:
|
||||
|
||||
```markdown
|
||||
<?xml version="1.0" encoding="UTF-8"?>
|
||||
<actual>
|
||||
<!-- содержимое корневого элемента -->
|
||||
<status lastUpd = "22.05.2025" checked = "true">
|
||||
Active
|
||||
</status>
|
||||
<media type = "online">
|
||||
Журнал «Код»
|
||||
</media>
|
||||
</actual>
|
||||
```
|
||||
|
||||
Новый элемент мы назвали `media` — так человеку будет проще прочитать и понять, что внутри, а компьютеру всё равно. Последнее — добавим информацию о составе редакции. Обратите внимание, что появилась вложенная структура: внутри элемента person есть три дочерних элемента: `name`, `lastname` и `role`. Это значит, что они относятся к родительскому элементу, а не живут сами по себе:
|
||||
|
||||
```markdown
|
||||
<?xml version="1.0" encoding="UTF-8"?>
|
||||
<actual>
|
||||
<!-- содержимое корневого элемента -->
|
||||
<status lastUpd = "22.05.2025" checked = "true">
|
||||
Active
|
||||
</status>
|
||||
<media type = "online">
|
||||
Журнал «Код»
|
||||
</media>
|
||||
<!-- редакция -->
|
||||
<person>
|
||||
<name>
|
||||
Михаил
|
||||
</name>
|
||||
<lastname>
|
||||
Полянин
|
||||
</lastname>
|
||||
<role>
|
||||
главред
|
||||
</role>
|
||||
</person>
|
||||
<person>
|
||||
<name>
|
||||
Кристина
|
||||
</name>
|
||||
<lastname>
|
||||
Тульцева
|
||||
</lastname>
|
||||
<role>
|
||||
редактор
|
||||
</role>
|
||||
</person>
|
||||
<person>
|
||||
<name>
|
||||
Игорь
|
||||
</name>
|
||||
<lastname>
|
||||
Росляков
|
||||
</lastname>
|
||||
<role>
|
||||
редактор
|
||||
</role>
|
||||
</person>
|
||||
</actual>
|
||||
```
|
||||
|
||||
Таким способом можно разобрать на логические составляющие любой технический или информационный документ — от инструкции к чайнику до ежегодного отчёта для инвесторов. Главное, не запутаться в элементах и чётко понимать, что от чего зависит и куда вкладывается.
|
||||
|
||||
### Секции CDATA
|
||||
|
||||
Это блок с дополнительными тегами внутри тега. Внутри можно вставить любой текст, даже спецсимволы. Выглядит так:
|
||||
|
||||
```markdown
|
||||
<cdata_example>
|
||||
<![CDATA[
|
||||
Внутри CDATA можно писать <, >, & без экранирования
|
||||
]]>
|
||||
</cdata_example>
|
||||
```
|
||||
|
||||
CDATA — способ сказать машине, чтобы она не обрабатывала этот блок как XML. Получается что-то вроде больших комментариев, но не совсем. CDATA затрудняет работу: поиск по этому разделу становится сложнее, он может мешать созданным шаблонам.
|
||||
|
||||
Главное, что XML создан для работы со структурированными данными, а CDATA работает как бы против этой идеи: это чёрный ящик, внутри которого может быть что угодно. Его нельзя проверить схемой, и он не поддерживает механизмы для усиления надёжности работы XML.
|
||||
|
||||
Иногда CDATA бывает полезен, но это особые случаи. Например, нужно встроить в файл фрагмент текста с большим количеством спецсимволов, такой как код.
|
||||
|
||||
## Где нужен XML-формат
|
||||
|
||||
XML применяют везде, где нужно выделить логическое содержимое документа, чтобы потом его можно было как-то обработать. Например, если у вас есть размеченный XML-файл с названием и характеристиками товаров, то можно научить сервер обрабатывать его как угодно: выводить название в заголовке или простым текстом, понимать, где лежит цена, откуда брать описание и к какому разделу отнести этот товар.
|
||||
|
||||
Ещё XML применяют в API, когда идёт ответ от сервера в виде XML-файлов.
|
||||
|
||||
## Как открыть XML-файл
|
||||
|
||||
Способов несколько. Всё зависит от того, что вы потом хотите сделать с файлом.
|
||||
|
||||
### На компьютере
|
||||
|
||||
Если файл нужно только открыть и просмотреть, проще всего перетащить его в поле адресной строки браузера. Редактировать нельзя, зато вся структура сразу видна:
|
||||
|
||||
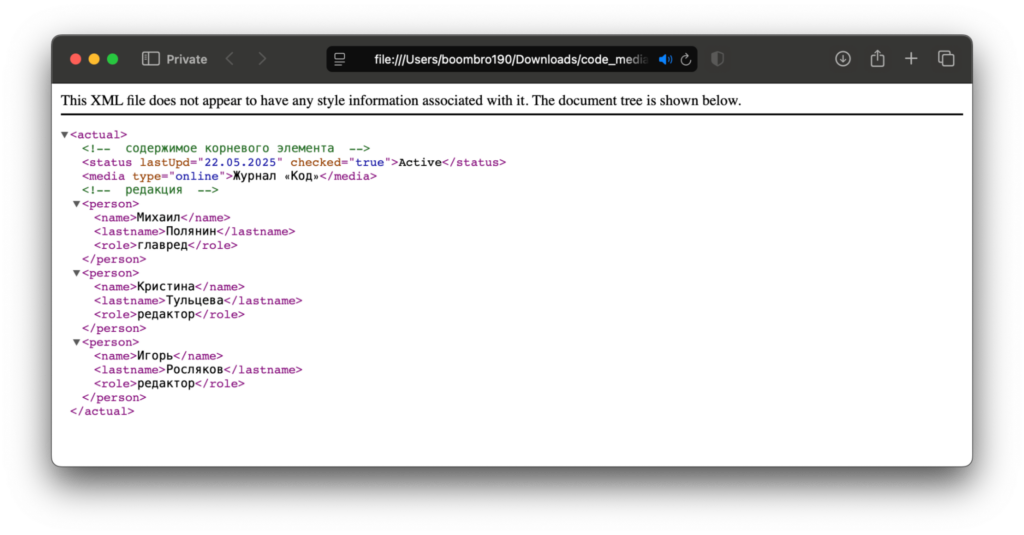
|
||||
|
||||
Что такое XML-формат и для чего он нужен
|
||||
|
||||
Самый простой инструмент для редактирования — Блокнот на Windows и TextEdit на MacOS. Можно менять содержимое, но просматривать его не так удобно, потому что нет подсветки синтаксиса:
|
||||
|
||||
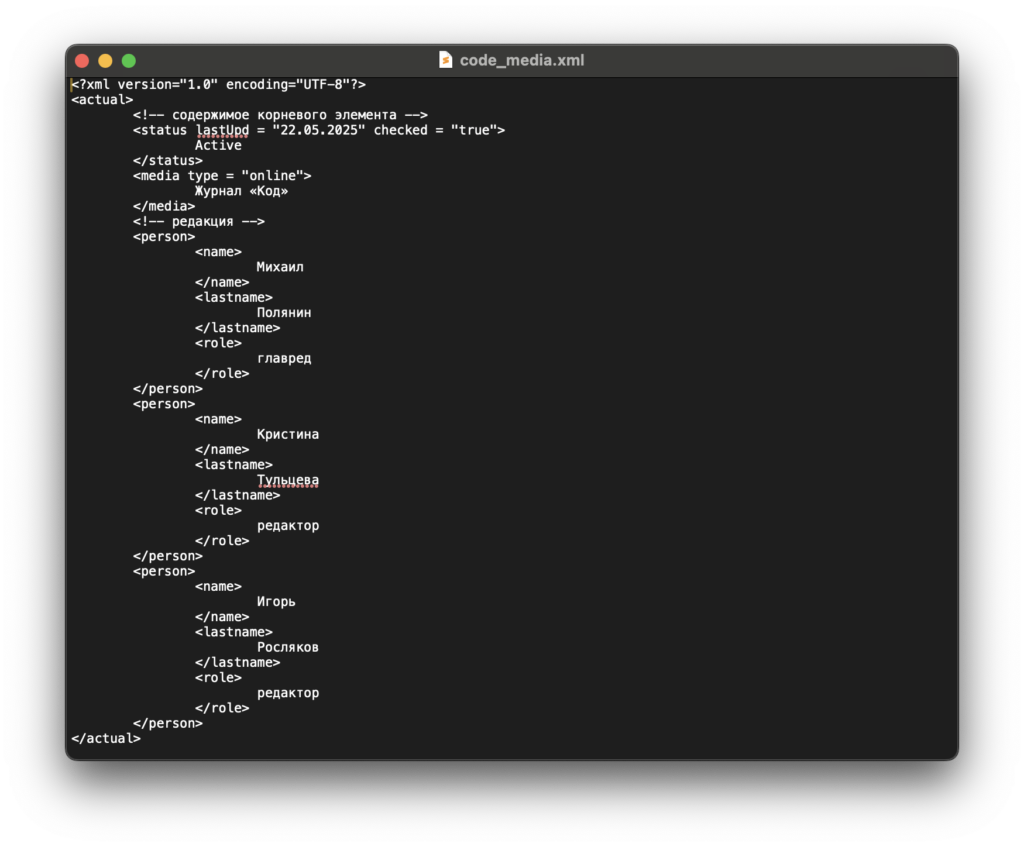
|
||||
|
||||
Что такое XML-формат и для чего он нужен
|
||||
|
||||
Более продвинутый вариант — использовать текстовые редакторы кода. Так будет выглядеть открытый файл в редакторе Sublime Text:
|
||||
|
||||
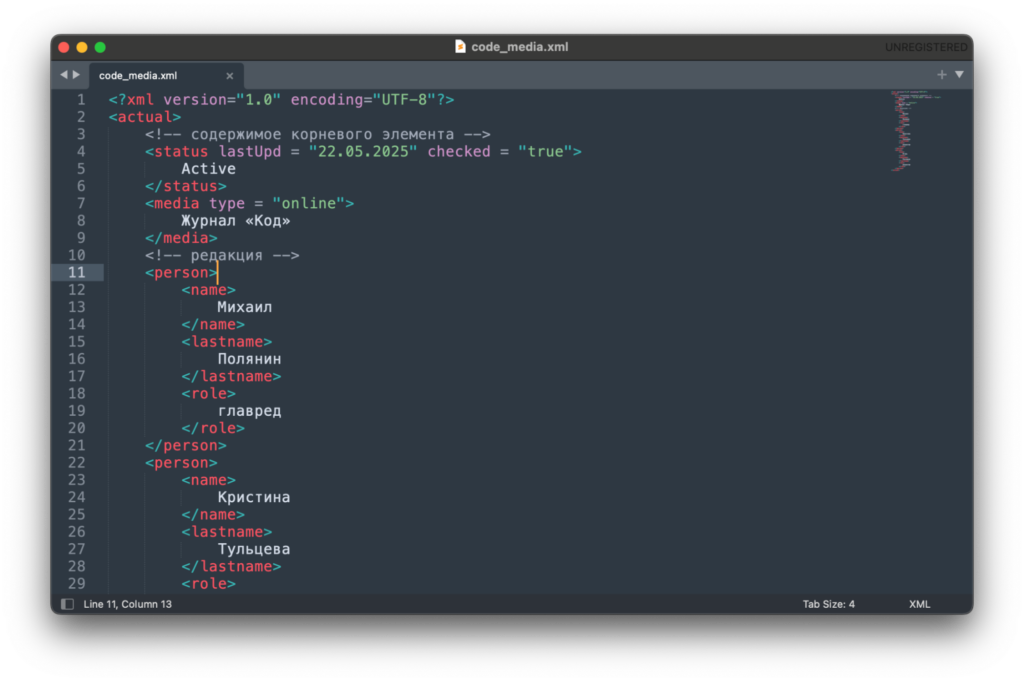
|
||||
|
||||
Что такое XML-формат и для чего он нужен
|
||||
|
||||
Самый мощный вариант — поставить IDE и всё делать в ней. Например, бесплатный настраиваемый Visual Studio Code:
|
||||
|
||||
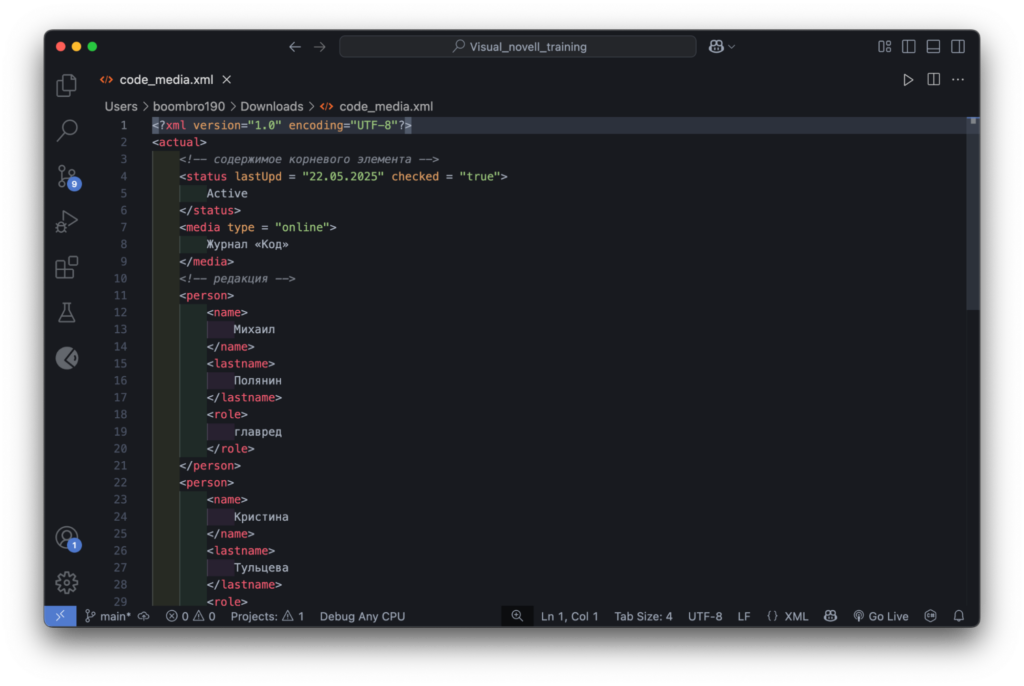
|
||||
|
||||
Что такое XML-формат и для чего он нужен
|
||||
|
||||
### На мобильных устройствах
|
||||
|
||||
По умолчанию XML на смартфоне можно открыть в браузере, так же как на компьютере:
|
||||
|
||||
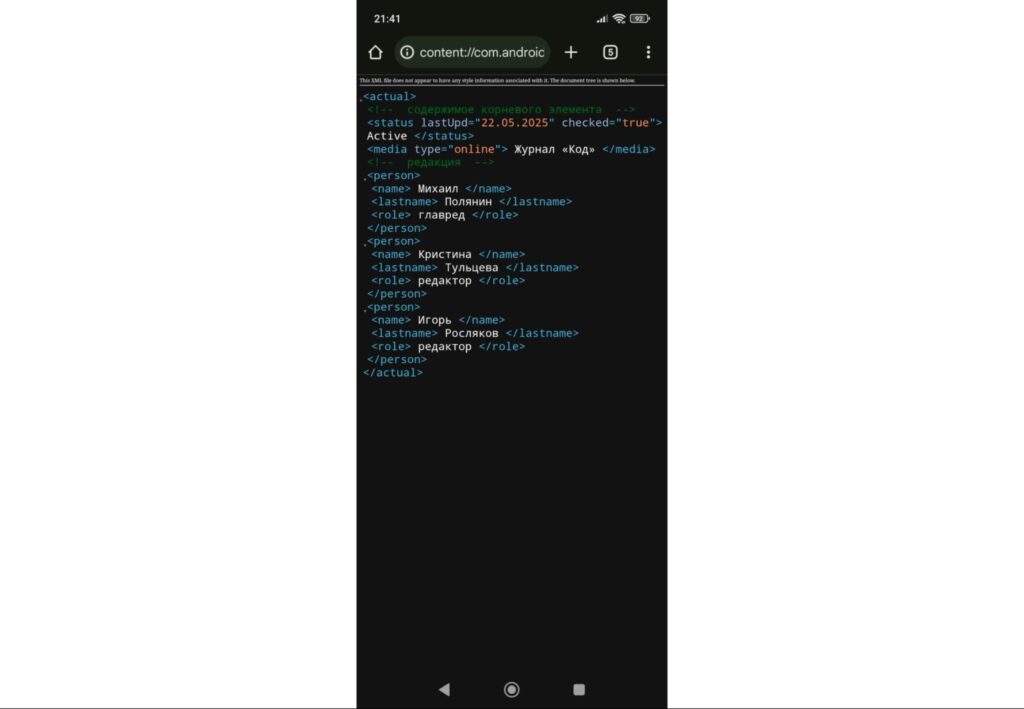
|
||||
|
||||
Что такое XML-формат и для чего он нужен
|
||||
|
||||
Если скачать отдельное приложение (их много, можно выбрать), файл можно открывать и редактировать в нём:
|
||||
|
||||
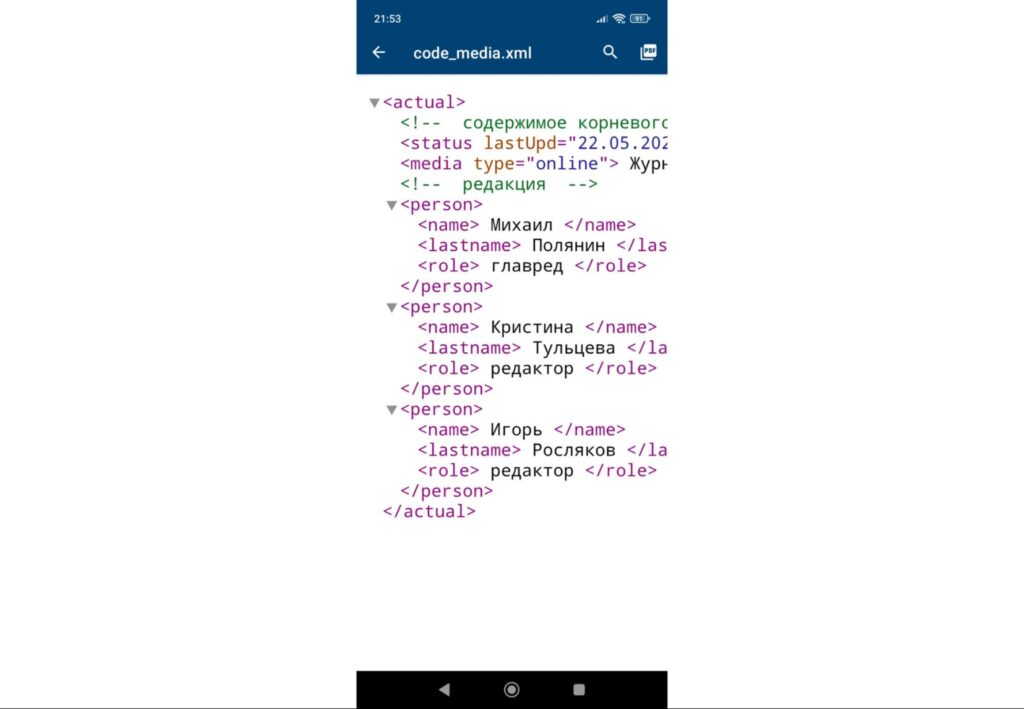
|
||||
|
||||
Что такое XML-формат и для чего он нужен
|
||||
|
||||
## Создание и редактирование XML файлов
|
||||
|
||||
Понадобится любой текстовый редактор или редактор кода. Минус текстового редактора в том, что там нет подсветки, поэтому лучше поставить что-нибудь для программирования.
|
||||
|
||||
Если не хотите разбираться в средах разработки, поставьте Sublime Text — он простой и удобный, там можно работать с любым текстом, его достаточно для всех простых задач, а если прокачать дополнительными плагинами, то можно спокойно писать и запускать код.
|
||||
|
||||
[Почему настоящие мастера пишут всё в Sublime Text](https://thecode.media/sublime-one-love/)
|
||||
|
||||
Для простого XML-файла нужно запомнить несколько правил.
|
||||
|
||||
Сначала пишем пролог:
|
||||
|
||||
```markup
|
||||
<?xml version="1.0" encoding="UTF-8"?>
|
||||
```
|
||||
|
||||
Потом ставим корневой тег:
|
||||
|
||||
```markup
|
||||
<?xml version="1.0" encoding="UTF-8"?>
|
||||
<root>
|
||||
<!-- тут будет всё содержимое XML -->
|
||||
</root>
|
||||
```
|
||||
|
||||
Внутри корневого тега можно создавать любые другие, но нужно помнить:
|
||||
|
||||
- Не забывайте ставить парные теги — один открывающий, другой закрывающий. Если работаете в IDE, для этого можно установить дополнительный плагин, который будет делать это за вас.
|
||||
- Регистр важен: нельзя написать один тег заглавными буквами, а другой строчными.
|
||||
- Все атрибуты внутри тегов должны быть указаны в кавычках: `<book id="101">`.
|
||||
- Спецсимволы, такие как угловые кавычки или амперсанд, нужно экранировать.
|
||||
|
||||
Созданный XML можно проверить валидаторами. Например, [jsonformatter.org](https://jsonformatter.org/xml-validator):
|
||||
|
||||
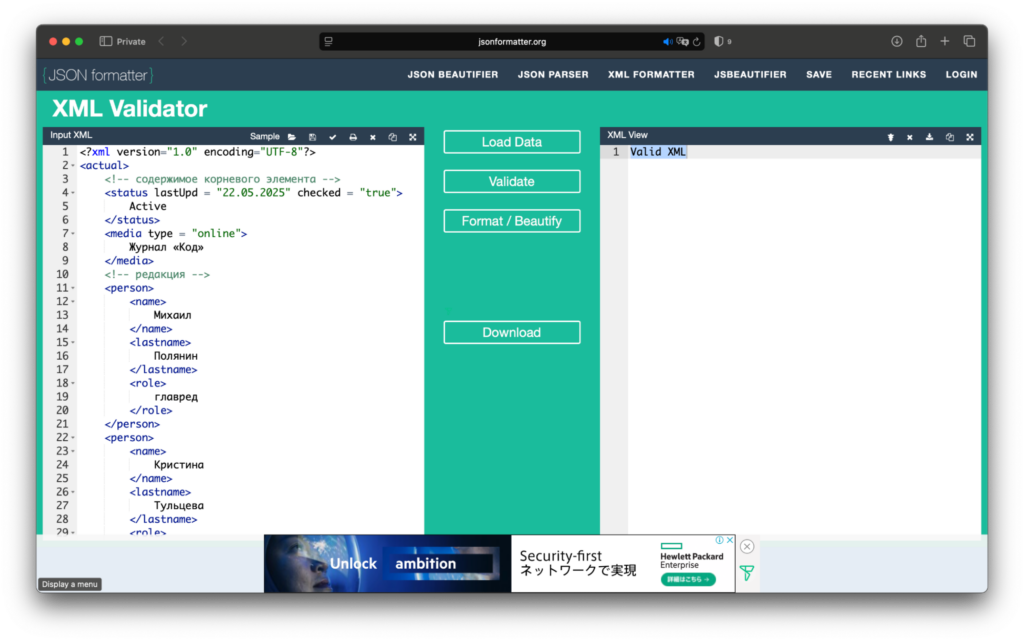
|
||||
|
||||
Что такое XML-формат и для чего он нужен
|
||||
|
||||
Или [w3schools.com](https://www.w3schools.com/xml/xml_validator.asp):
|
||||
|
||||
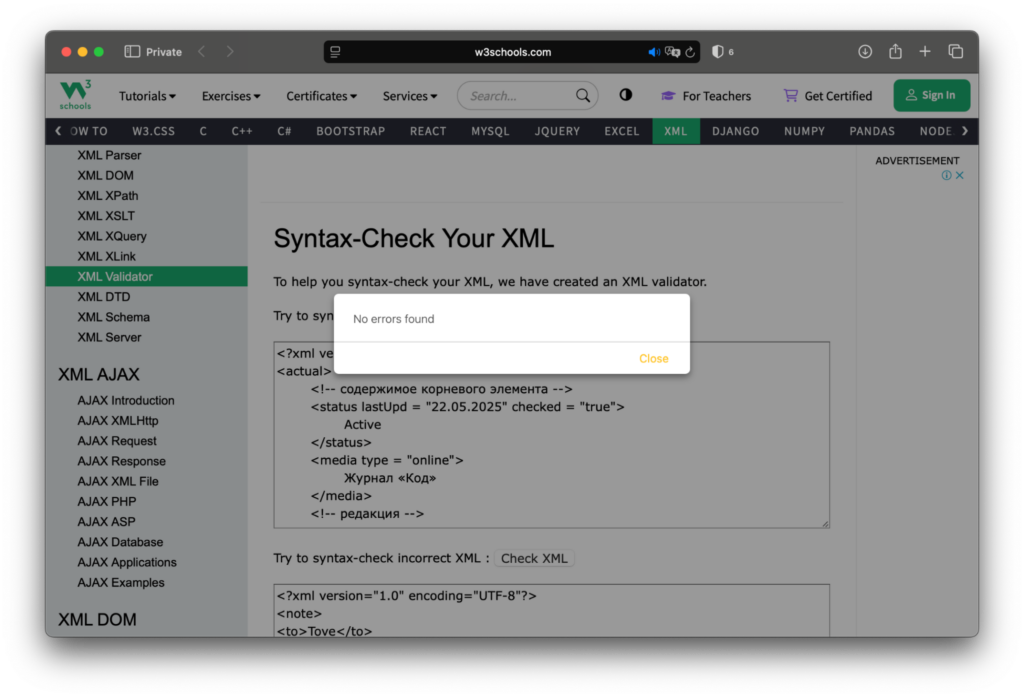
|
||||
|
||||
Что такое XML-формат и для чего он нужен
|
||||
|
||||
## Что дальше
|
||||
|
||||
В другой статье придумаем свой XML-формат и научим сервер с ним работать. Так тоже можно. В конце концов, это ИТ, тут можно вообще почти всё.
|
||||
|
||||
## Вам слово
|
||||
|
||||
Приходите к нам в соцсети поделиться своим мнением о формате XML и почитать, что пишут другие. А ещё там выходит дополнительный контент, которого нет на сайте — шпаргалки, опросы и разная дурка. В общем, вот [тележка](https://v.thecode.media/gfjty), вот [ВК](https://v.thecode.media/lmw36) — велком!
|
||||
@@ -0,0 +1,50 @@
|
||||
---
|
||||
title: "Кабель FT8 для Xiegu G90/G106"
|
||||
source: "https://dzen.ru/a/aPVQ38CKA00Bm47l"
|
||||
author:
|
||||
- "[[RAZA Аномальные зоны России]]"
|
||||
published:
|
||||
created: 2026-01-27
|
||||
description: "Статья автора «RAZA Аномальные зоны России» в Дзене ✍: Трансивер Xiegu G106 весьма привлекателен своей компактностью. При его 5 ваттах на выходе, вас прекрасно слышат в SSB."
|
||||
tags:
|
||||
- "clippings"
|
||||
---
|
||||
[RAZA Аномальные зоны России](https://dzen.ru/razaward)
|
||||
|
||||
Трансивер Xiegu G106 весьма привлекателен своей компактностью. При его 5 ваттах на выходе, вас прекрасно слышат в SSB. Но на нем можно и работать в FT8 через кабель со смартфона. Причем стандартные...
|
||||
|
||||
Трансивер Xiegu G106 весьма привлекателен своей компактностью. При его 5 ваттах на выходе, вас прекрасно слышат в SSB. Но на нем можно и работать в FT8 через кабель со смартфона. Причем стандартные кабеля, которые продаются на маркетах не определяются смартфоном. Я попробовал разобраться в этом вопросе и нашел простое решение.
|
||||
|
||||

|
||||
|
||||
Готовый кабель
|
||||
|
||||
Разъем гарнитуры в смартфоне называется миниджек TRRS. Он имеет 4 контакта и отличается от обычного TRS тем, что корпусной контакт расположен не на основании разъема. Правильную распайку разъема вы видите на картинке.
|
||||
|
||||

|
||||
|
||||
Распайка TRRS
|
||||
|
||||
Наша задача подать на микрофон смартфона сигнал AF-OUT и сигнал наушников на AF-IN. Все просто, да не просто. Если просто вставить джек в смартфон - ничего не произойдет и звук не пойдет в этот разъем. Все потому, что смартфон отпределяет по сопротивлению микрофона и наушников подключение гарнитуры. Как это обойти? Да просто припаять резисторы параллельно. 1.5 килоома к микрофону и 1 килоом к наушникам.
|
||||
|
||||
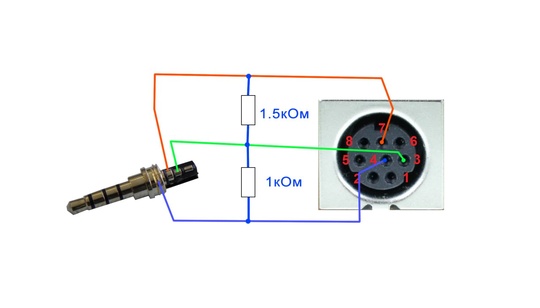
|
||||
|
||||
Правильная распайка кабеля
|
||||
|
||||
После этого провод будет определяться смартфоном и звук пойдет куда нужно. Разъем ACC в трансивере имеет маркировку MDN-8M.
|
||||
|
||||
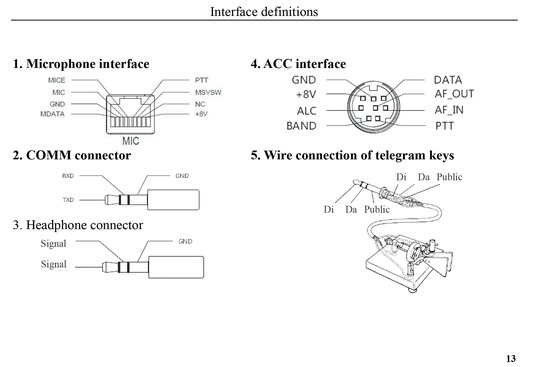
|
||||
|
||||
Распайки на XIEGU
|
||||
|
||||
Я припаял резисторы прямо на разъем, используя типоразмер 0805. А как сделаете вы?
|
||||
|
||||
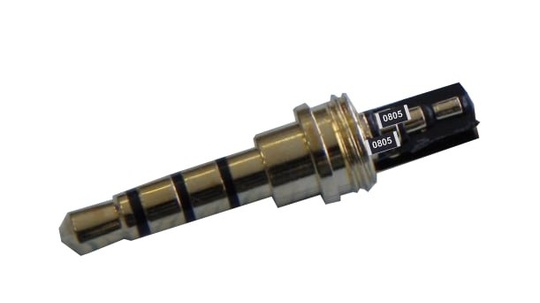
|
||||
|
||||
Резисторы типоразмера 0805 на разъеме trrs 3.5
|
||||
|
||||
Если нема такого разъема в телефоне ? через звуковую карту получится в USB перейти ?
|
||||
|
||||
Dima V, https://www.ozon.ru/product/usb-a-na-3-5-mm-trrs-adapter-belyy-port-tipa-c-2882482086/?at=99trQpqgqcD7x2OgHNZvZ7jU9jAGmwINOOlgxtjyO6kX
|
||||
|
||||
для юсб звуковухи синий общий провод на два разъема, красный в гнездо микрофона, зеленый в гнездо наушников.
|
||||
@@ -0,0 +1,73 @@
|
||||
---
|
||||
title: "Как передать реальный ip клиента через nginx proxy manager lcx?"
|
||||
source: "https://qna.habr.com/q/1253998"
|
||||
author:
|
||||
- "[[Хабр Q&A — вопросы и ответы]]"
|
||||
published: 2023-02-18
|
||||
created: 2026-02-10
|
||||
description: "Всем привет!На роутере проброшен 80 и 44 порт на контейнер lxc (не докер) с nginx proxy manager, он в свою очередь перенаправляет на виртуалку с Xpenology, как в Xpenology получать реальные адреса пользователей ? В Xpenology все клиенты, которые подключаются через домен, им присваивается адрес контейнера с nginx Пробовал добавить вот такие \"префиксы\", все равно никакАдрес сети 192.168.8.0/24Адрес контейнера 192.168.8.9/24Адрес Xpenology 192.168.8.3/24Адрес роутера 192.168.8.1/24Ip бе"
|
||||
tags:
|
||||
- "clippings"
|
||||
---
|
||||
Всем привет!
|
||||
На роутере проброшен 80 и 44 порт на контейнер lxc (не докер) с nginx proxy manager, он в свою очередь перенаправляет на виртуалку с Xpenology, как в Xpenology получать реальные адреса пользователей? В Xpenology все клиенты, которые подключаются через домен, им присваивается адрес контейнера с nginx
|
||||
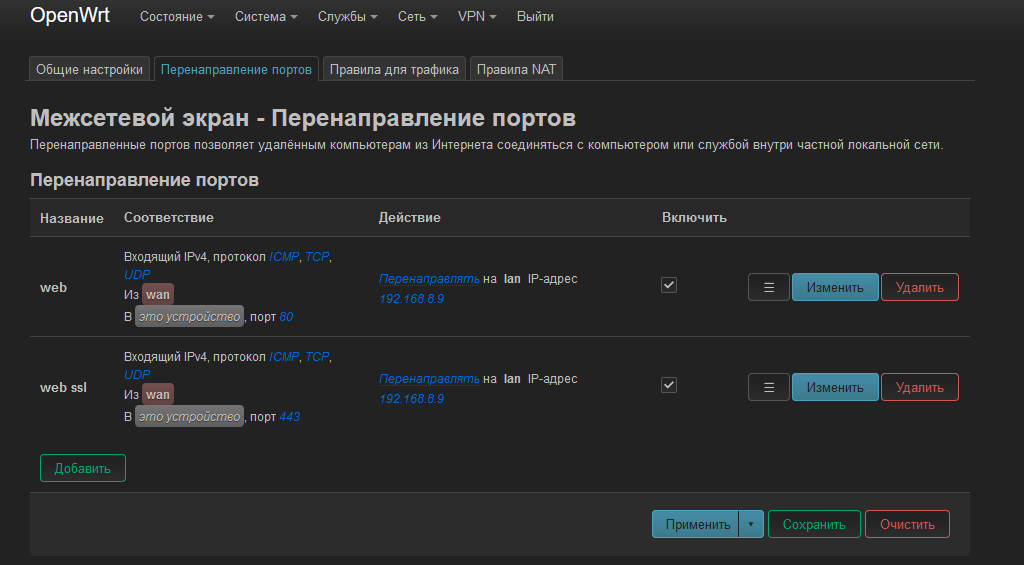
|
||||

|
||||
Пробовал добавить вот такие "префиксы", все равно никак
|
||||
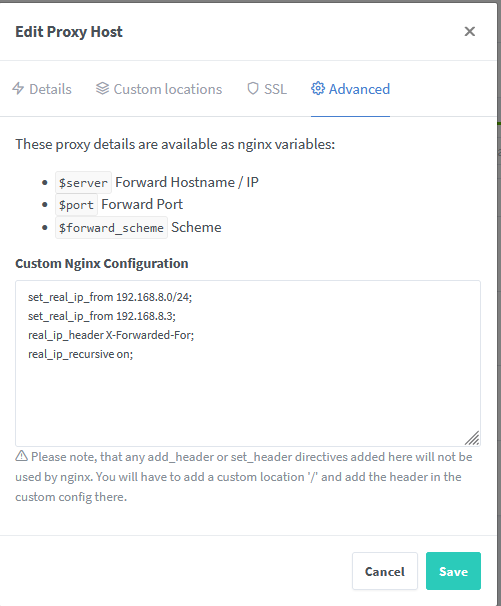
|
||||
|
||||
Адрес сети 192.168.8.0/24
|
||||
Адрес контейнера 192.168.8.9/24
|
||||
Адрес Xpenology 192.168.8.3/24
|
||||
Адрес роутера 192.168.8.1/24
|
||||
Ip белый
|
||||
|
||||
- 4407 просмотров
|
||||
|
||||
Подписаться 1 Простой
|
||||
|
||||
[Реклама](https://company.habr.com/ru/advertising/ "Медийная реклама")
|
||||
|
||||
Решение проблемы
|
||||
необходимо
|
||||
на роутере с Openwrt (как в других - не подскажу)
|
||||
1.Либо отключить Маскарадинг из WAN либо создать правило НАТ, которое бы разрешало для proxy сервера получать ip внешние, а не роутера
|
||||

|
||||
или
|
||||
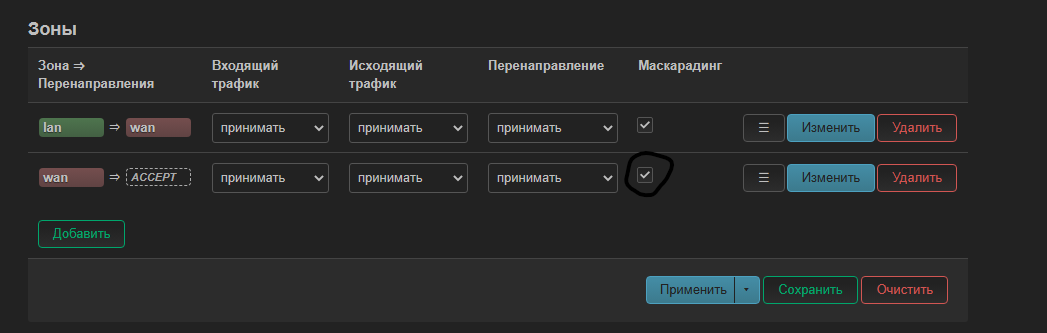
|
||||
2\. Если вы используете Nginx Proxy Manager (в докере или в lxc контейнере), то в проксируемом хосте, вкладка advansed необходимо добавить следующее
|
||||
proxy\_set\_header Host $http\_host;
|
||||
proxy\_set\_header X-Real-IP $remote\_addr;
|
||||
proxy\_set\_header X-Forwarded-For $proxy\_add\_x\_forwarded\_for;
|
||||
proxy\_set\_header X-Forwarded-Proto $scheme;
|
||||
(конфиг фаил править не нужно)
|
||||
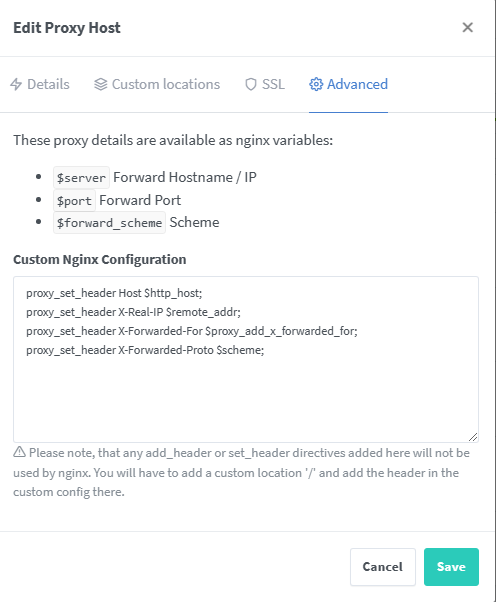
|
||||
3\. в самом Synology (или Xpenology, разницы нет) необходимо зайти
|
||||
Панель управления - Безопасность - вкладка Безопасность
|
||||
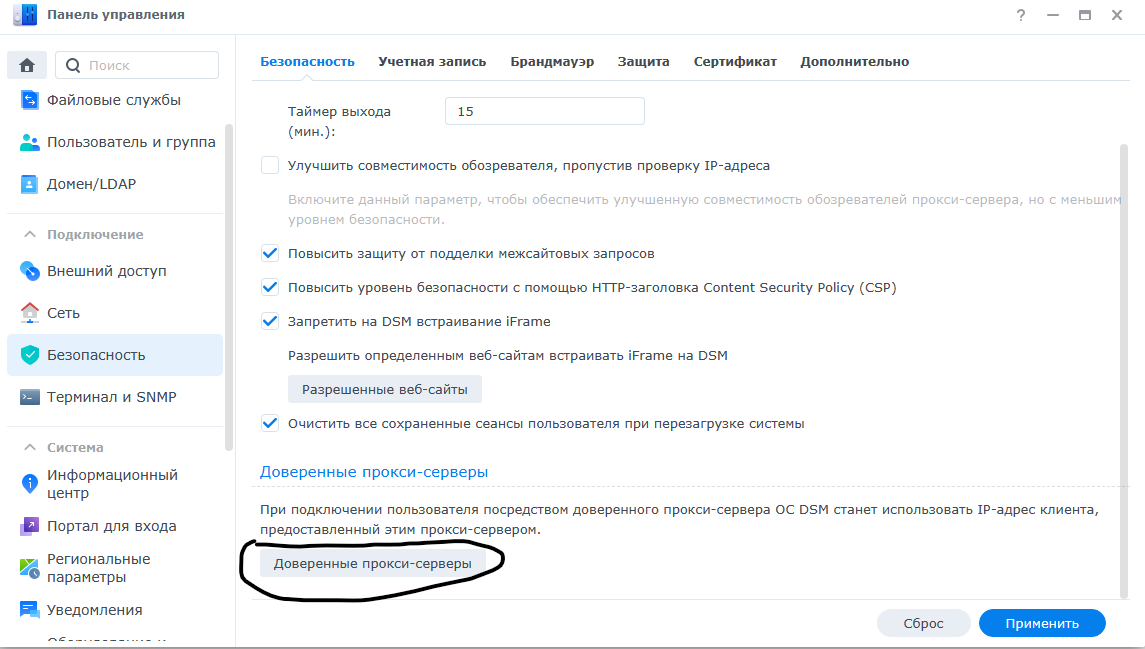
|
||||
В самом низу "Доверенные Прокси-серверы" и там указать адрес вашего прокси сервера с маской через слэш
|
||||
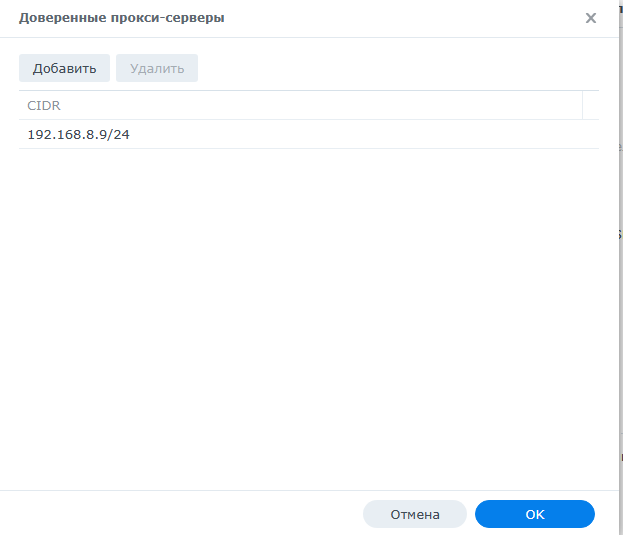
|
||||
|
||||
Ответ написан
|
||||
|
||||
[Пригласить эксперта](https://qna.habr.com/q/#)
|
||||
|
||||
### Войдите, чтобы написать ответ
|
||||
|
||||
[Middle FullStack Developer (PHP / Laravel / Vue)](https://career.habr.com/vacancies/1000164345?utm_source=tm_toster&utm_medium=tm_section&utm_campaign=vacancies_post)
|
||||
|
||||
[ЛЕДДЕР](https://career.habr.com/companies/ledder?utm_source=tm_toster&utm_medium=tm_section&utm_campaign=vacancies_post) • Казань
|
||||
|
||||
от 150 000 ₽
|
||||
|
||||
[SRE / DevOps инженер (bare metal, highload media platform)](https://career.habr.com/vacancies/1000164894?utm_source=tm_toster&utm_medium=tm_section&utm_campaign=vacancies_post)
|
||||
|
||||
[Karma8](https://career.habr.com/companies/karma8?utm_source=tm_toster&utm_medium=tm_section&utm_campaign=vacancies_post)
|
||||
|
||||
от 350 000 ₽
|
||||
|
||||
[ML / NLP Engineer (чат-боты, LLM)](https://career.habr.com/vacancies/1000164752?utm_source=tm_toster&utm_medium=tm_section&utm_campaign=vacancies_post)
|
||||
|
||||
[FIN](https://career.habr.com/companies/fin?utm_source=tm_toster&utm_medium=tm_section&utm_campaign=vacancies_post) • Лимассол
|
||||
|
||||
от 4 000 до 6 000 $
|
||||
+209
@@ -0,0 +1,209 @@
|
||||
---
|
||||
title: "Что такое Swagger: инструмент для подготовки документации к API и проведения тестов API — журнал «Код»"
|
||||
source: https://thecode.media/chto-takoe-swagger-i-kak-on-oblegchaet-rabotu-s-api/
|
||||
author:
|
||||
published: 2024-11-20
|
||||
created: 2025-08-24
|
||||
description: Swagger — инструмент, который умеет автоматически создавать описание для каждого ресурса в REST API, показывать доступные методы, параметры запроса и ответы.
|
||||
tags:
|
||||
- clippings
|
||||
- "#swagger"
|
||||
---
|
||||
Мы уже рассказывали, что такое [API](https://thecode.media/api/), но на всякий случай напомним: это то, что может делать приложение по просьбе других приложений. Чтобы функциями API могли пользоваться другие люди, они должны знать, какие запросы можно отправлять, что нужно передавать в ответах и что вернётся. Всю эту информацию разработчики API указывают в документации. Но обычно вручную делать такие описания долго, особенно если API большой и функциональный, поэтому разработчики используют специальные инструменты для создания документации. Один из них — Swagger — мы сегодня и разберём.
|
||||
|
||||
## Что такое Swagger и как он связан с REST API
|
||||
|
||||
API — это набор команд, которые разработчики добавляют в приложение, чтобы другие программы могли с этим приложением взаимодействовать. Допустим, есть [сервис](https://github.com/alexwohlbruck/cat-facts) для получения фактов о кошках, и нужно, чтобы другие приложения тоже могли запрашивать эти факты. Для этого используется API, который задаёт правила для взаимодействия. С помощью запросов к этому API можно получить случайные факты о кошках.
|
||||
|
||||
Есть несколько подходов к созданию API. Один из самых популярных — архитектура REST API (Representational State Transfer). Она описывает, как должен быть устроен API, чтобы с ним всем было удобно работать.
|
||||
|
||||
В этой архитектуре каждый объект или ресурс в приложении («пользователи», «факты», «задачи») имеет свой уникальный URL, который называется эндпоинтом. Эндпоинт — это адрес, по которому отправляется запрос к API, и для работы с ним используются стандартные HTTP-методы: GET для получения данных или POST — для создания новых данных. REST API работает по принципу «без сохранения состояния» — то есть каждый запрос обрабатывается как самостоятельное действие, не зависящее от предыдущих запросов.
|
||||
|
||||
Чтобы объяснить другим принцип работы своего API, разработчики пишут документацию. Там они описывают, какие действия поддерживает API, как отправлять запросы, какие данные можно получить в ответ и так далее. Получается что-то вроде этого:
|
||||
|
||||
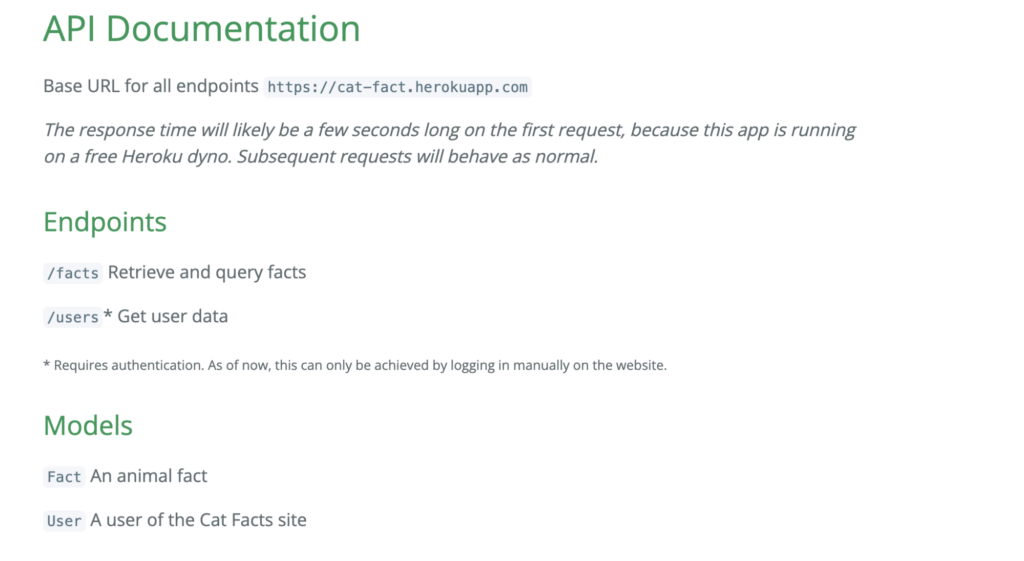
|
||||
|
||||
Что такое Swagger и как он облегчает работу с API
|
||||
|
||||
Пример документации API для приложения Cat Facts: указан основной URL, эндпоинты и модели данных
|
||||
|
||||
Чтобы упростить себе жизнь, разработчики используют разные инструменты, которые помогают создавать документацию. Один из них — [Swagger](https://swagger.io/). Он умеет автоматически создавать описание для каждого ресурса в REST API, показывать доступные методы, параметры запроса и ответы, поскольку заточен под REST API и работает с теми же стандартами URL и HTTP-методов.
|
||||
|
||||
Swagger берёт все ресурсы, методы и параметры, заданные в API, и превращает их в наглядное описание. В результате мы можем увидеть, какие запросы поддерживаются, какие данные нужно передавать и что возвращается в ответ. Документация, которую создаёт Swagger, будет выглядеть так:
|
||||
|
||||
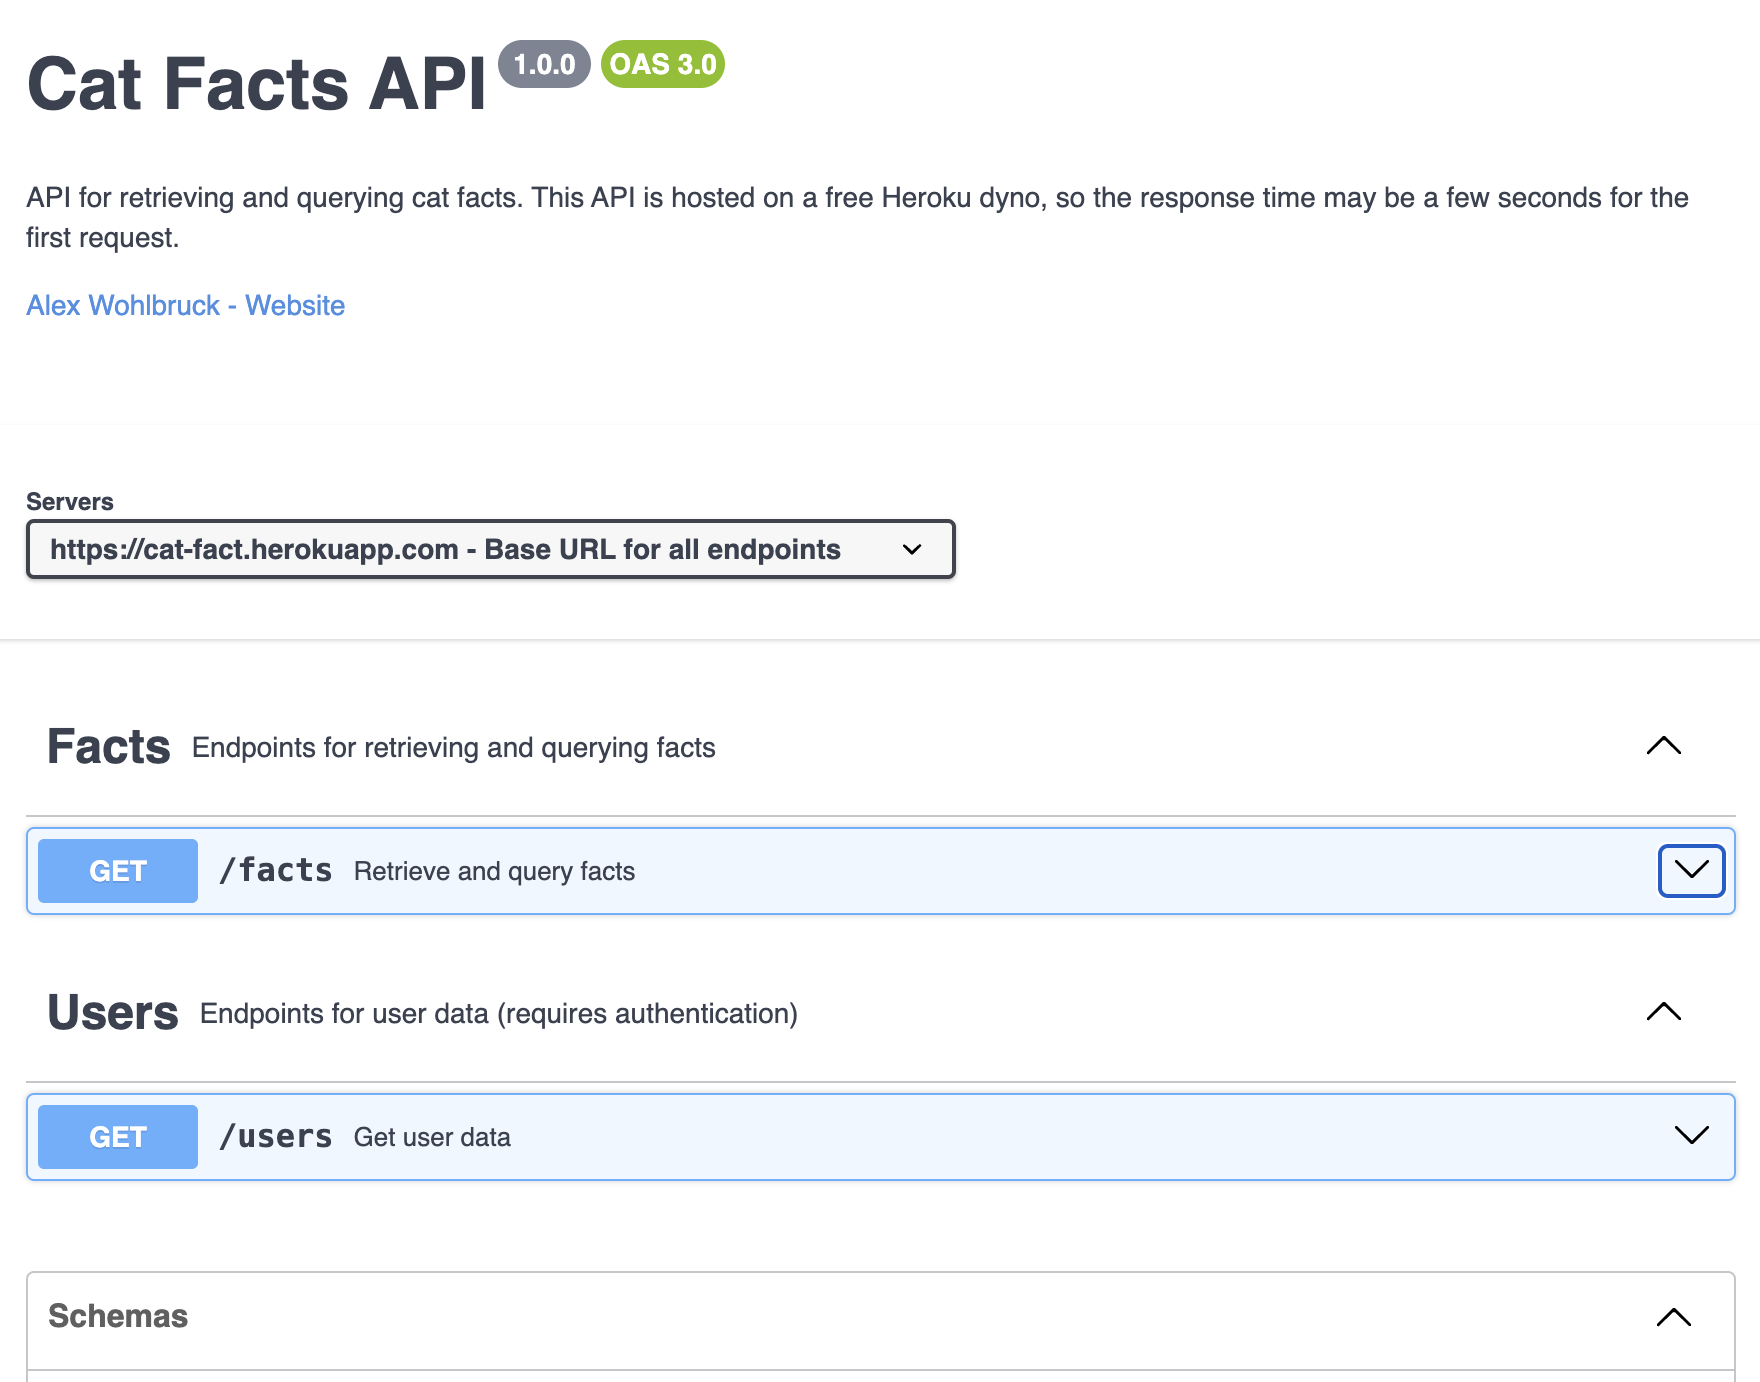
|
||||
|
||||
Что такое Swagger и как он облегчает работу с API
|
||||
|
||||
Пользователь сразу видит структуру API. Можно раскрыть запрос и протестировать его выполнение прямо в браузере:
|
||||
|
||||
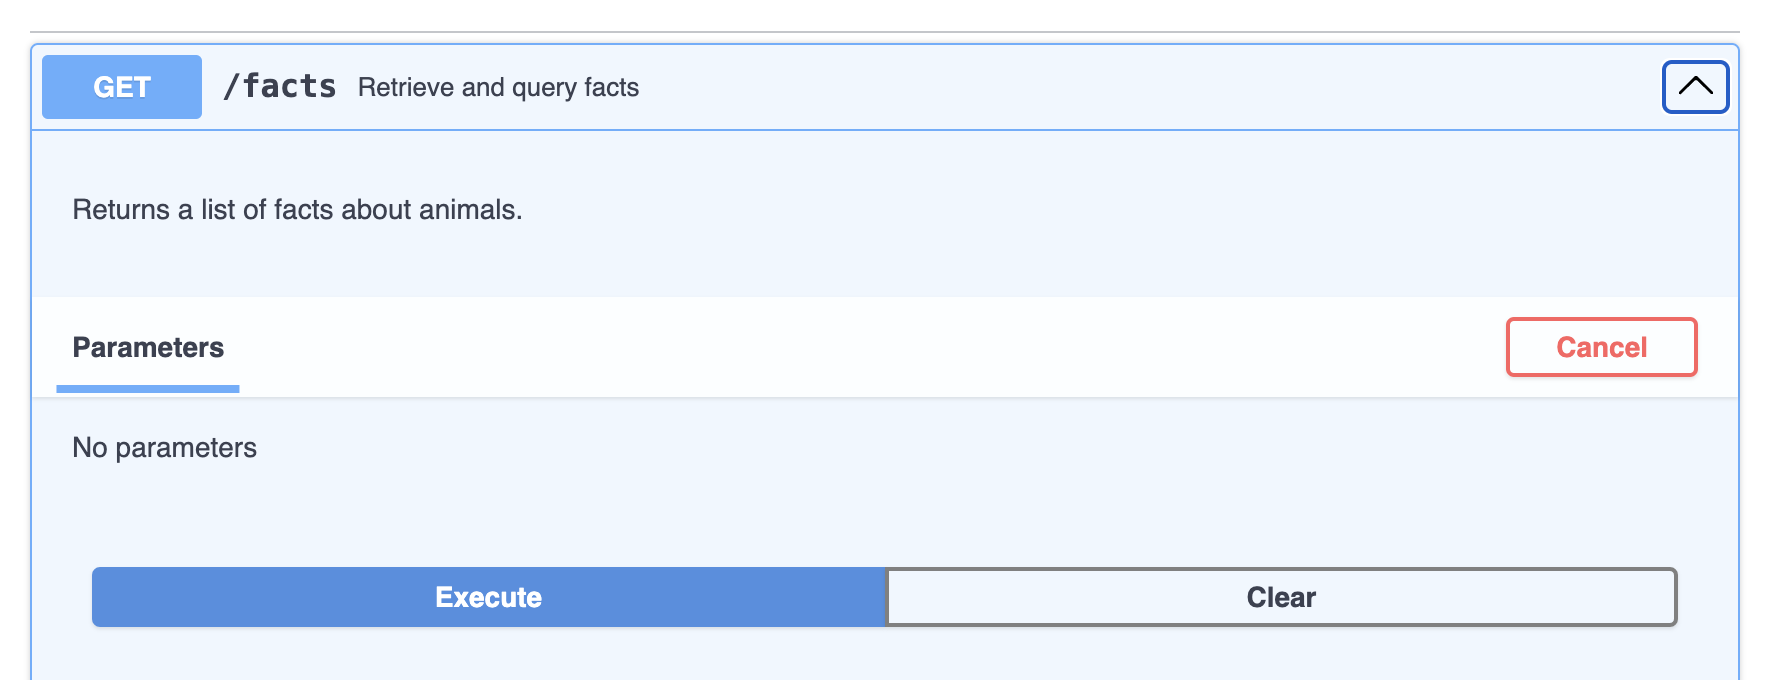
|
||||
|
||||
Что такое Swagger и как он облегчает работу с API
|
||||
|
||||
## Для чего используется Swagger
|
||||
|
||||
Мощь Swagger — в его интерактивности. Инструмент создаёт документацию, где каждый запрос, параметры и ответ можно сразу протестировать. Это позволяет быстро проверить, как работает каждый метод, и если нужно, то сразу сделать отладку.
|
||||
|
||||
Swagger стал настолько популярным, что сейчас разные разработчики и компании воспринимают его как стандартный инструмент для работы с API. Его используют для создания и документирования API как для внутренних целей, так и для внешних клиентов.
|
||||
|
||||
Инструмент могут использовать разные специалисты, которые работают с API: разработчики, системные аналитики, тестировщики, а также проектные и продуктовые менеджеры. В зависимости от роли и задач использование будет разным.
|
||||
|
||||
Теперь разберём подробнее.
|
||||
|
||||
### ➡️ Как используют Swagger разработчики API
|
||||
|
||||
**Создают и поддерживают документацию.** Это обязательный этап при проектировании API, особенно если он будет использоваться другими командами или клиентами. В Swagger разработчик может описать каждый эндпоинт, добавить методы, параметры и возможные ответы.
|
||||
|
||||
**Тестируют API.** Можно выбрать эндпоинт, задать параметры и отправить запрос, чтобы увидеть, как API обрабатывает данные. Это позволяет сразу проверить, правильно ли работает каждый метод. Swagger показывает, какой ответ приходит от API — формат JSON и коды ошибок.
|
||||
|
||||
**Генерируют клиентский код для API.** Если API нужно подключить к приложению, Swagger Codegen позволяет создать клиентский код для работы с этим API на более чем 40 языках программирования. Swagger также может создавать серверные заглушки, которые представляют API, но без фактической бизнес-логики. Это позволяет начать разработку клиентской части параллельно с серверной, так как клиент может тестировать API, даже если сервер ещё не готов.
|
||||
|
||||
**Синхронизируют работу в команде.** Swagger помогает командам избегать путаницы при разработке API и иметь доступ к актуальной документации. Если один разработчик добавляет новый эндпоинт, это сразу же видно всем, кто работает с этим API. Клиентская и серверная команды могут одновременно тестировать API и проверять, что все методы и параметры работают как нужно.
|
||||
|
||||
В общем, если нужно создавать с нуля свой API, то Swagger точно пригодится.
|
||||
|
||||
### ➡️ Как используют Swagger системные аналитики
|
||||
|
||||
У аналитиков всё несколько по-другому: их задача не столько в написании кода, сколько в анализе и координации работы API, а также в проверке соответствия требованиям. Вот что они делают.
|
||||
|
||||
**Анализируют текущее состояние API.** Swagger позволяет изучить структуру API и понять, какие данные он обрабатывает и какие функции поддерживает. Это помогает на этапе планирования: можно оценить, насколько API соответствует целям проекта, и сразу увидеть, какие ресурсы и методы уже реализованы, а какие нужно добавить.
|
||||
|
||||
**Взаимодействуют с разработчиками и заказчиками.** Документацию Swagger удобно демонстрировать заказчикам: используя Swagger, аналитики могут показать, какие возможности есть у API, и объяснить его работу простыми словами, не вдаваясь в технические аспекты.
|
||||
|
||||
**Проверяют соответствие API требованиям.** Аналитики проверяют, что каждый метод, ресурс и параметр соответствует установленным задачам. Если API меняется, аналитик может сразу увидеть, соответствует ли новое решение изначальным ожиданиям, и вовремя внести корректировки и передать задачи команде разработки.
|
||||
|
||||
Вам может быть интересно:
|
||||
|
||||
[ Что такое API](https://thecode.media/chto-takoe-api/) [ Что такое вебхук](https://thecode.media/webhook/) [ Космическая Python-программа: следим за МКС](https://thecode.media/kosmicheskaya-python-programma-sledim-za-mks/) [ Делаем HTTP-запросы на Python с библиотеками requests, aiohttp и httpx](https://thecode.media/delaem-http-zaprosy-na-python-s-bibliotekami-requests-aiohttp-i-httpx/)
|
||||
|
||||
## Компоненты Swagger
|
||||
|
||||
В Swagger есть два вида компонентов: компоненты-инструменты и компоненты спецификации.
|
||||
|
||||
Разные инструменты решают разные задачи. Допустим, если нужно только создать документацию, достаточно Swagger Editor, а если надо ещё и полноценно протестировать разные сценарии использования — то Swagger UI. Инструменты доступны через официальный сайт [https://swagger.io/](https://swagger.io/)
|
||||
|
||||
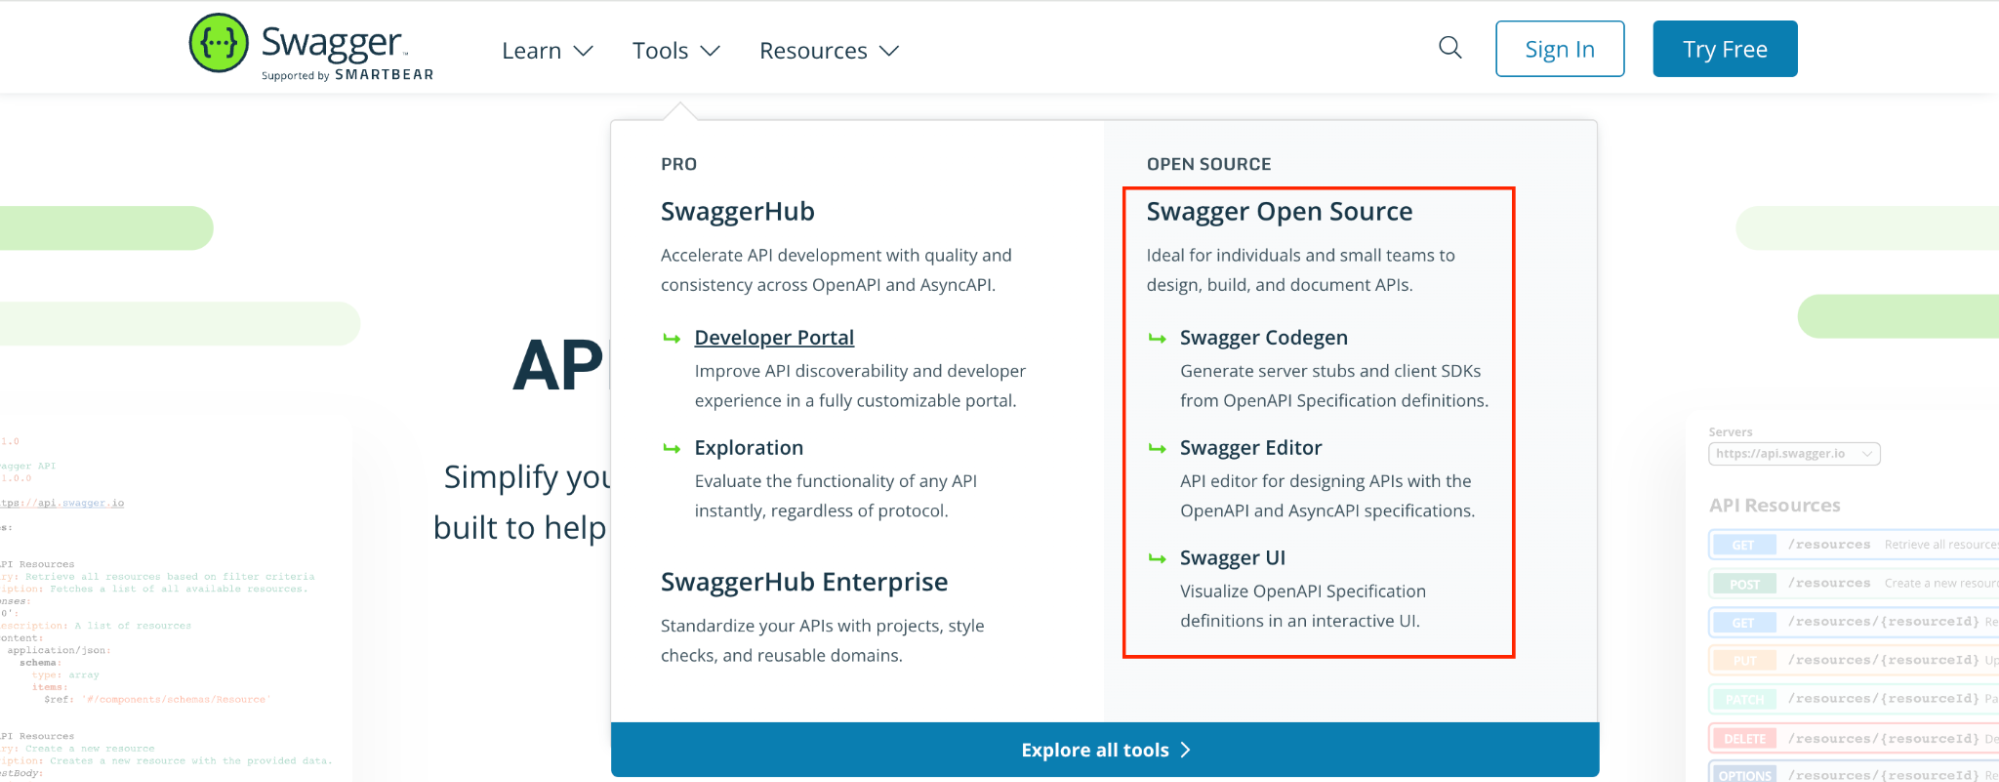
|
||||
|
||||
Что такое Swagger и как он облегчает работу с API
|
||||
|
||||
Разберём три основных.
|
||||
|
||||
- [**Swagger Editor**](https://editor.swagger.io/)**:** позволяет писать документацию, проектировать и описывать новые API, а также редактировать существующие. Инструмент работает в браузере, визуально отображает документацию и подсвечивает ошибки. Можно сделать базовое тестирование запросов. Также можно установить и запустить локально.
|
||||
- [**Swagger UI**](https://swagger.io/tools/swagger-ui/)**:** настраиваемый инструмент, который визуализирует документацию для API. Подключается к API и позволяет взаимодействовать с ним прямо в браузере. С его помощью можно изучить структуру API и полноценно протестировать его, задавая параметры и отправляя запросы в режиме реального времени.
|
||||
- [**Swagger Codegen**](https://github.com/swagger-api/swagger-codegen)**:** создаёт готовый клиентский код для работы с уже описанным API. Если у вас есть документация, созданная вручную или с помощью Swagger UI, то Swagger Codegen может использовать эту документацию для автоматической генерации клиентских библиотек на разных языках. Codegen можно сразу подключить к проекту и использовать его как модуль для работы с API.
|
||||
|
||||
Компоненты спецификации — это то, из чего состоит документация API. Это разделы, которые организуют и структурируют описание:
|
||||
|
||||
Такая структура называется спецификацией OpenAPI:
|
||||
|
||||
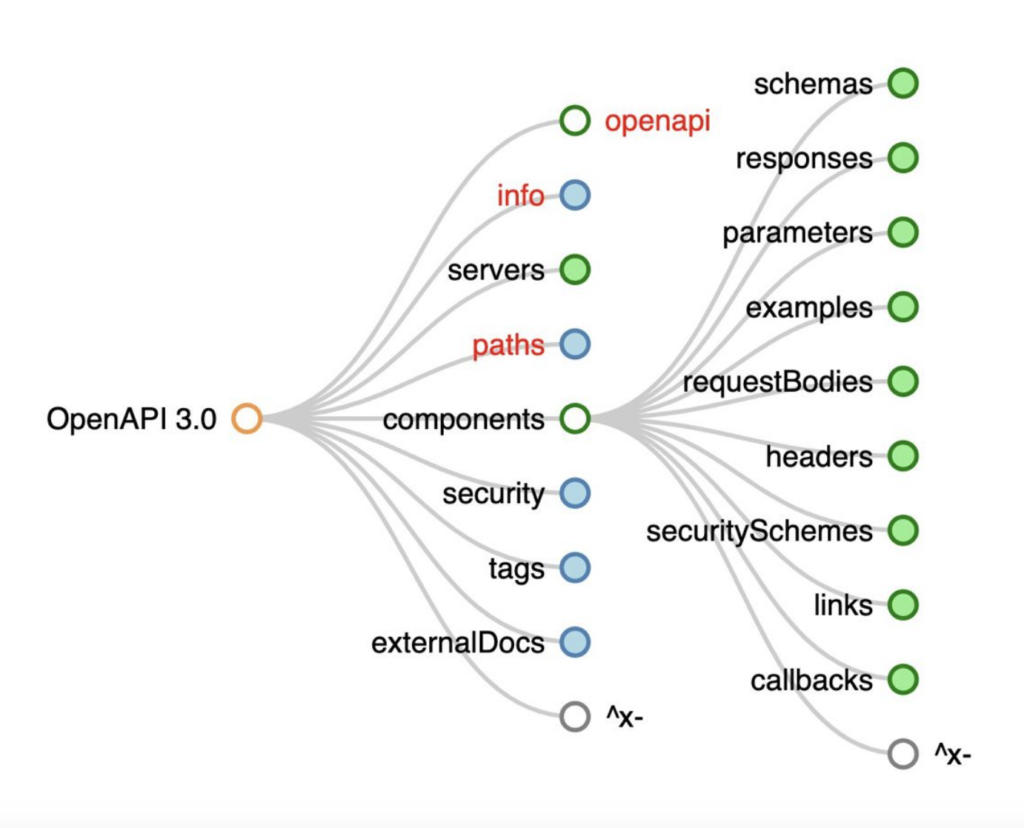
|
||||
|
||||
Что такое Swagger и как он облегчает работу с API
|
||||
|
||||
Когда в документации мы выносим общие описания в отдельные компоненты, это сокращает код. Получается, что, описав один раз параметры или ответы, можно использовать их в разных местах. Если нужно что-то изменить, достаточно обновить компонент один раз, и изменения сразу отразятся во всех запросах, где он используется.
|
||||
|
||||
## Как начать работать со Swagger
|
||||
|
||||
Самый простой способ — использовать [онлайн-версию](https://editor.swagger.io/) Swagger Editor. При запуске редактор автоматически загружает пример API — шаблон в формате YAML, разбитый на компоненты. В формате YAML используются отступы и структура с вложенностью, а не скобки или кавычки, поэтому он выглядит более простым для восприятия — сразу понятно, что к чему относится.
|
||||
|
||||
Можно использовать его как основу, удаляя ненужные компоненты и добавляя свои данные. Swagger Editor сразу покажет, как будет выглядеть документация на основе описания.
|
||||
|
||||
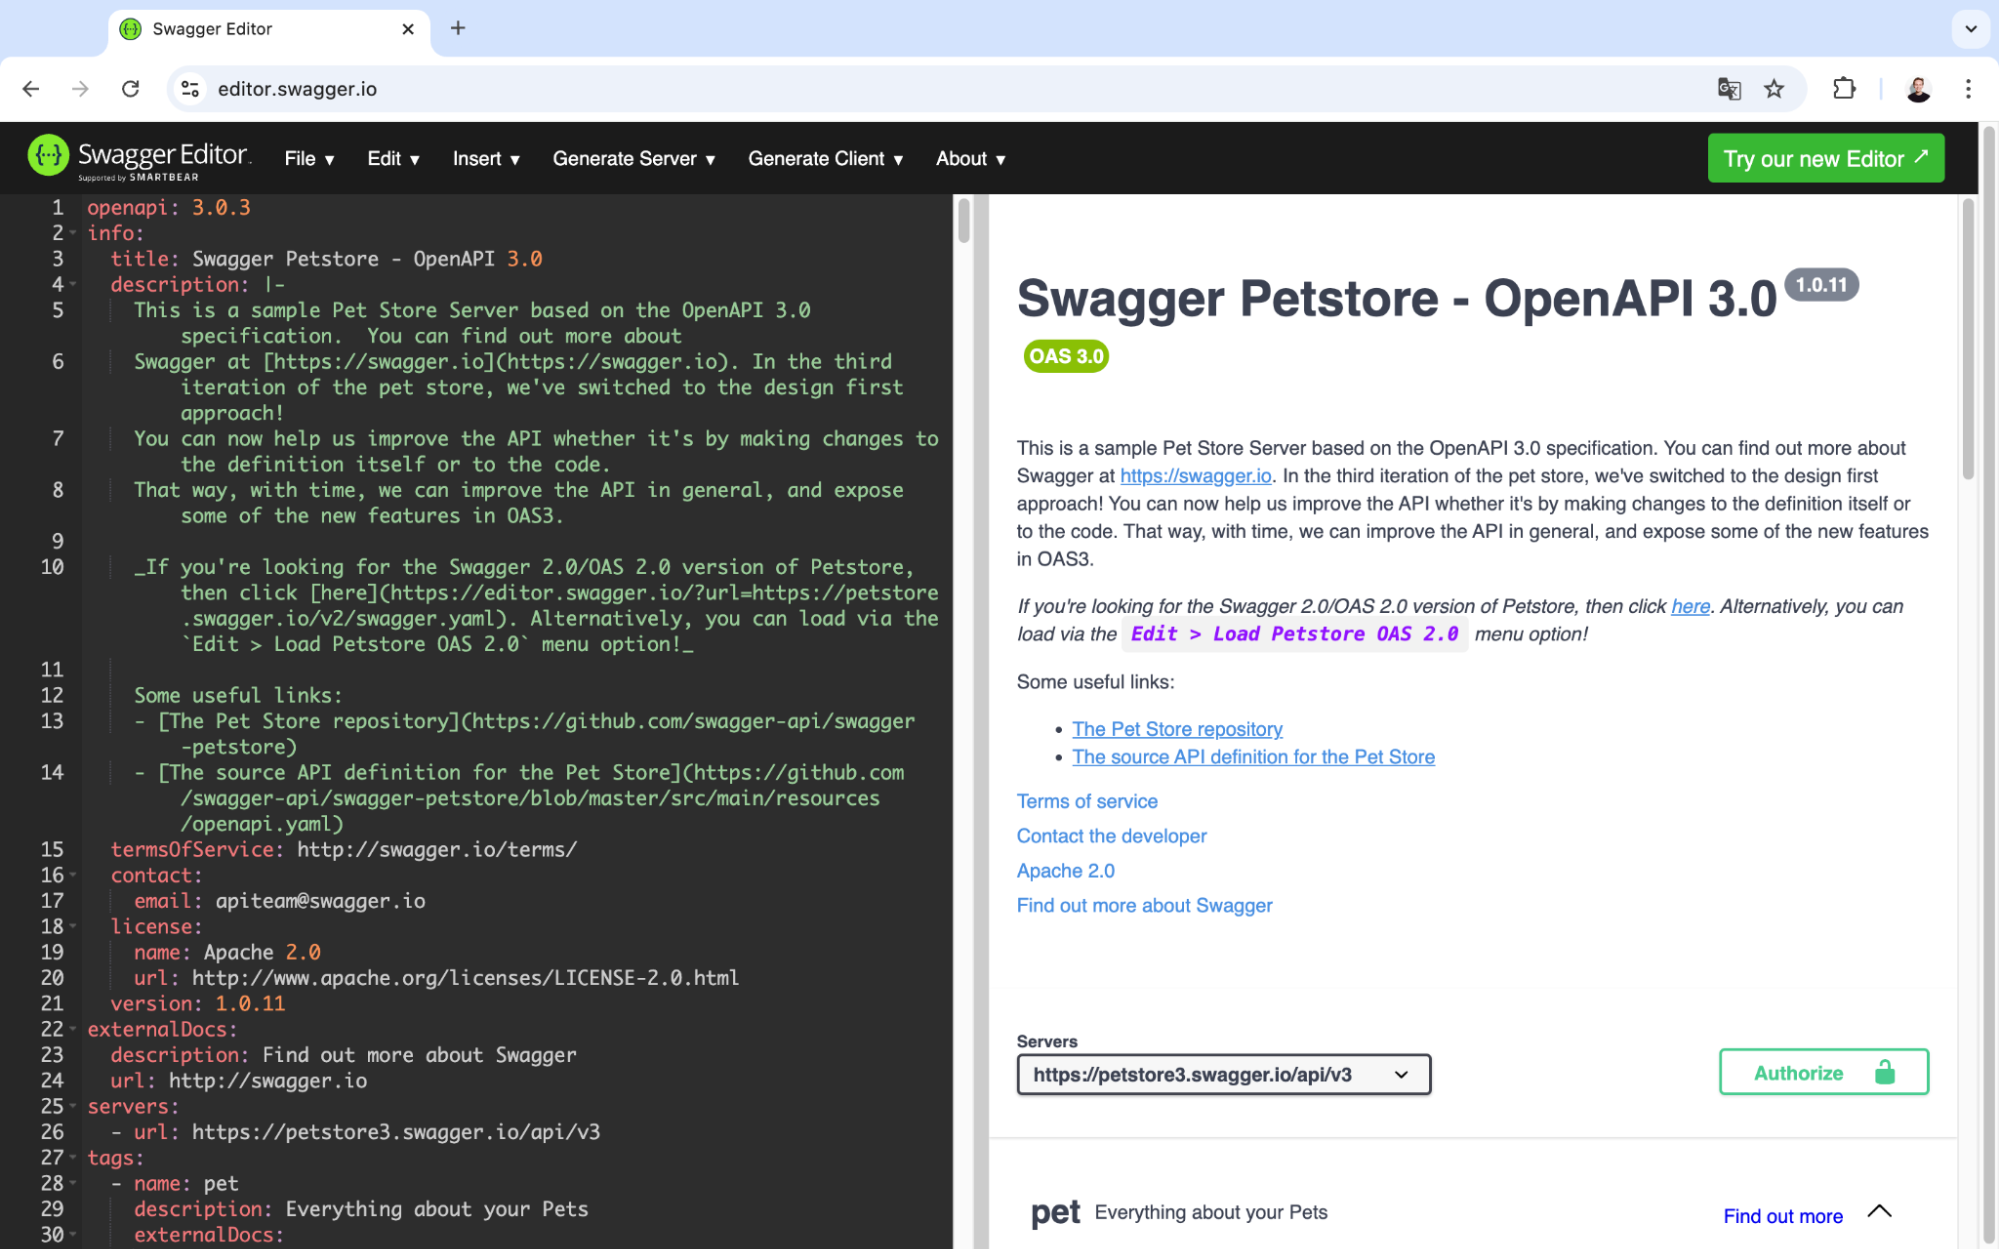
|
||||
|
||||
Шаблон OpenAPI по умолчанию
|
||||
|
||||
Если есть файл документации в формате OpenAPI (файл с расширением.yaml или.json), его можно загрузить в редактор. Для этого нажимаем на вкладку File, выбираем Import File и загружаем файл со своего компьютера:
|
||||
|
||||
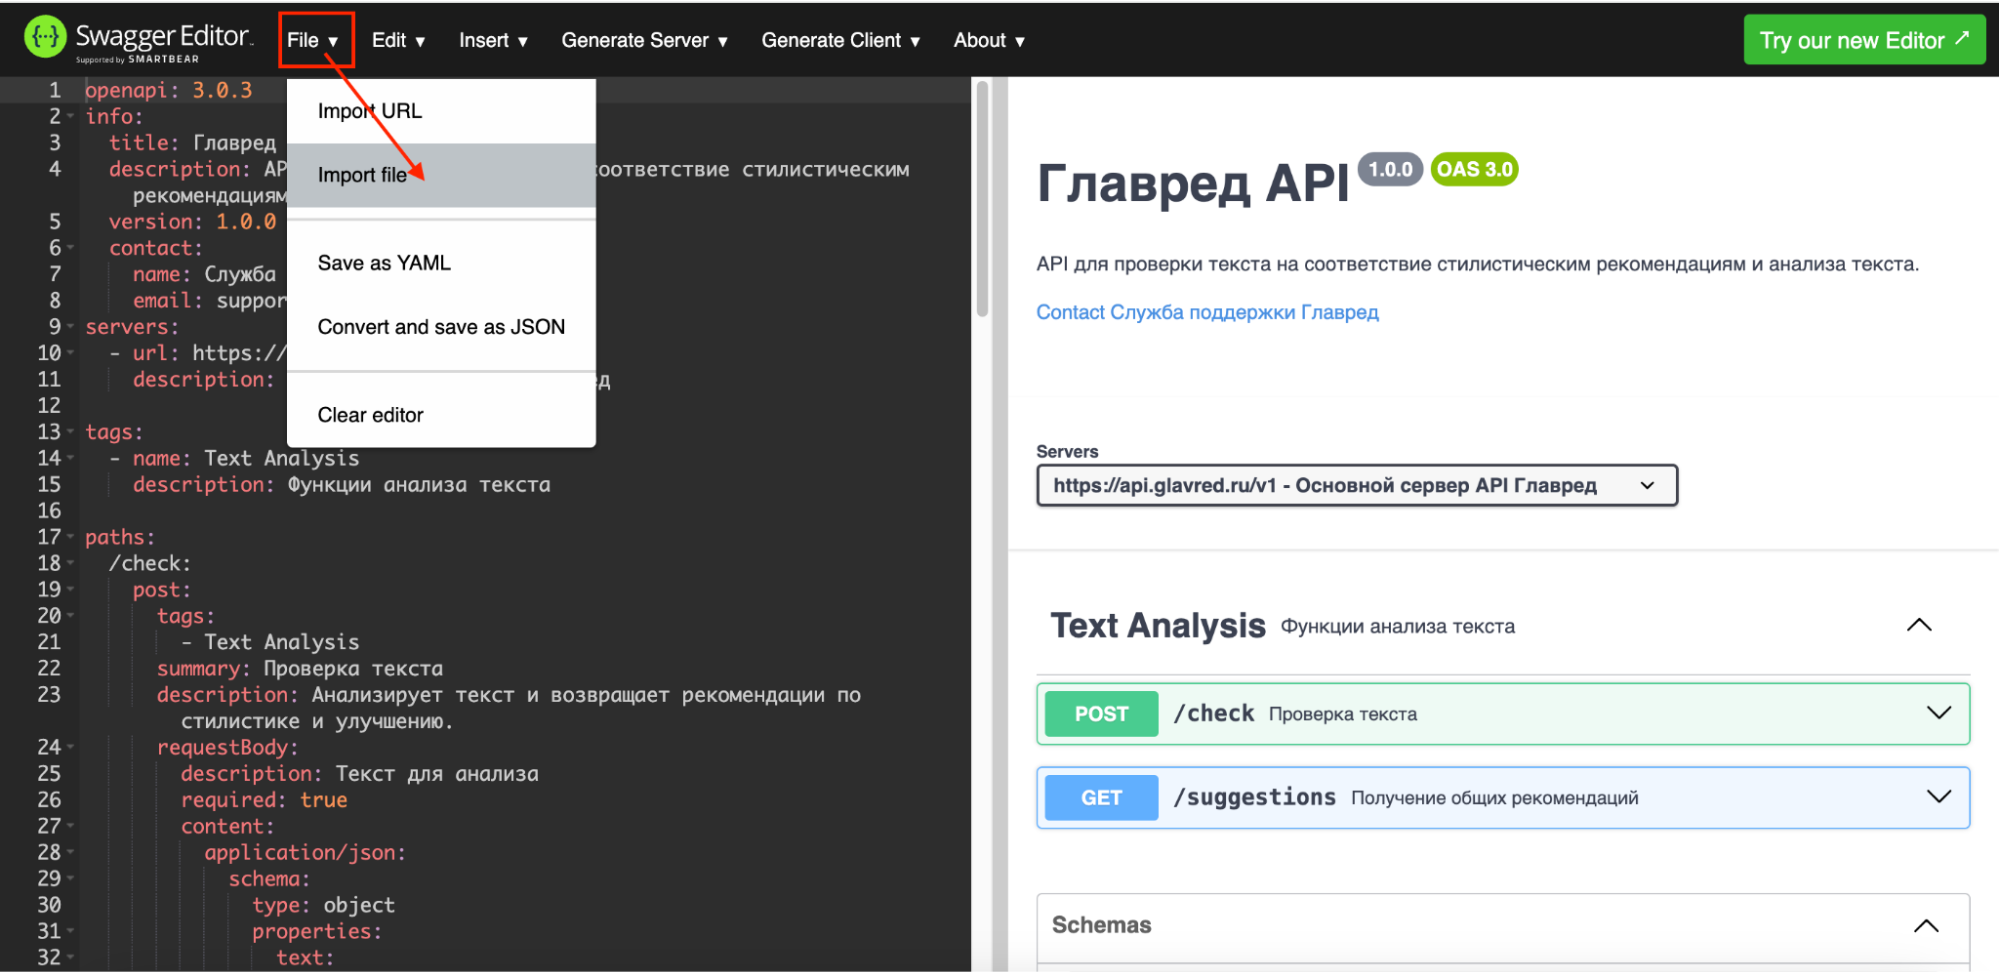
|
||||
|
||||
Что такое Swagger и как он облегчает работу с API
|
||||
|
||||
Если мы сделаем ошибку в структуре или синтаксисе файла, то инструмент подсветит её и даст рекомендации по исправлению. Например, есть убрать какое-то обязательное поле в документации (в примере ниже — `version`), то Swagger Editor укажет нам на ошибку в структуре:
|
||||
|
||||
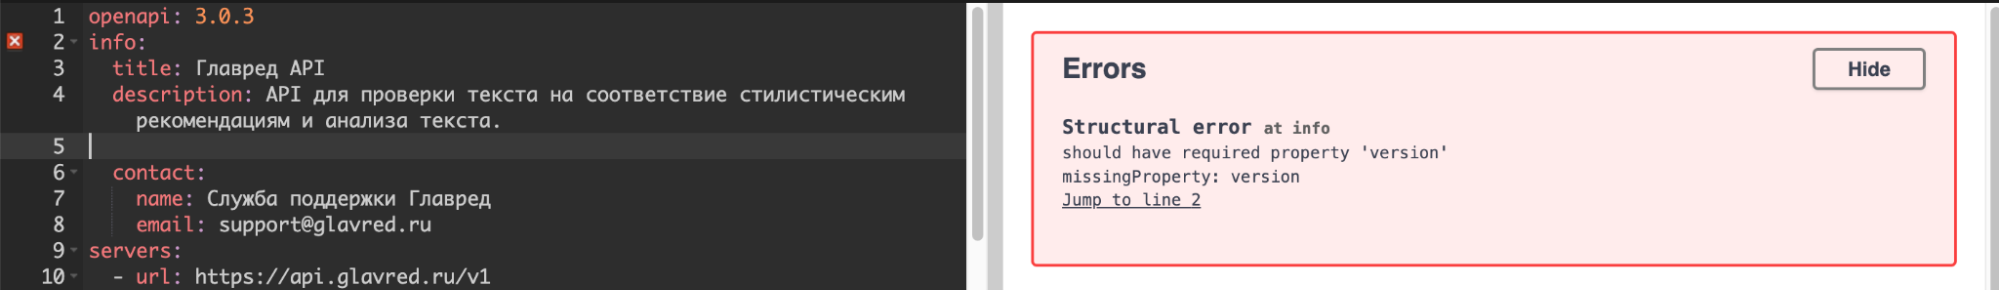
|
||||
|
||||
Что такое Swagger и как он облегчает работу с API
|
||||
|
||||
Если хотите работать локально, скачайте Swagger Editor с [GitHub](https://github.com/swagger-api/swagger-editor) и запустите его на своём компьютере.
|
||||
|
||||
Чтобы генерировать документацию из проекта, понадобится Swagger UI. Он умеет создавать спецификации OpenAPI, читая аннотации исходного кода API. Чтобы его установить, нужно скачать Swagger UI с GitHub. Для этого переходим на [GitHub Swagger UI](https://github.com/swagger-api/swagger-ui) и скачиваем репозиторий. Дальше в зависимости от того, на каком языке написан проект, можно либо подключить Swagger UI через фреймворк ([Flask-RESTX](https://flask-restx.readthedocs.io/en/latest/) для Python, [Springfox](https://springfox.github.io/springfox/) для Java), либо использовать Swagger UI как статическое веб-приложение и подключить к нему файл спецификации OpenAPI нашего API.
|
||||
|
||||
Дальше разберём более подробно, как это работает, на примере Python-проекта.
|
||||
|
||||
## Методы создания документации
|
||||
|
||||
Документацию в Swagger можно создавать двумя способами: вручную и через генератор.
|
||||
|
||||
Вручную документация пишется в [Swagger Editor](https://swagger.io/tools/swagger-editor/). Там мы подробно описываем весь наш API в компонентах OpenAPI: какие в нём есть команды, какие данные можно передавать, что API вернёт в ответ.
|
||||
|
||||
Второй способ — это генерация через [Swagger UI](https://github.com/swagger-api/swagger-ui). В исходном коде API разработчики добавляют специальные аннотации, которые описывают функции API: какие команды доступны, какие параметры принимают и что возвращают. Для создания таких аннотаций обычно подключают сторонние библиотеки.
|
||||
|
||||
Допустим, у нас есть Python-код какого-то API, который мы хотим задокументировать. В свой проект мы подключаем библиотеку Flask и расширение для аннотирования flask\_restx, чтобы с помощью аннотации `@api.doc` добавить описание для каждого метода. Swagger UI прочитает все аннотации и автоматически отобразит документацию по ним.
|
||||
|
||||
Сначала добавляем Flask и расширение Flask-RESTX, которые позволят дальше работать со Swagger. Открываем терминал и пишем команду:
|
||||
|
||||
```markup
|
||||
pip install flask flask-restx
|
||||
```
|
||||
|
||||
Теперь возьмём код нашего API и аннотируем метод:
|
||||
|
||||
```python
|
||||
# Импортируем Flask для создания веб-приложения
|
||||
from flask import Flask, request, jsonify
|
||||
# Импортируем Api и Resource из flask_restx для создания и документирования API
|
||||
from flask_restx import Api, Resource
|
||||
# Создаём экземпляр приложения Flask
|
||||
app = Flask(__name__)
|
||||
# Создаём объект API с названием и описанием
|
||||
api = Api(app, title="Главред API", description="API для проверки текста")
|
||||
# Определяем маршрут /check для обработки запросов по этому URL
|
||||
@api.route('/check')
|
||||
# Создаём класс TextCheck, который наследует Resource
|
||||
class TextCheck(Resource):
|
||||
# Аннотация для Swagger с описанием, что делает этот метод
|
||||
@api.doc(description="Проверка текста на стилистические ошибки")
|
||||
# Определяем метод POST для маршрута /check
|
||||
def post(self):
|
||||
# Логика проверки текста
|
||||
return jsonify({"result": "Текст проверен"})
|
||||
# Проверяем, запущен ли этот файл напрямую
|
||||
if __name__ == '__main__':
|
||||
# Запускаем приложение Flask с включённым режимом отладки (debug)
|
||||
app.run(debug=True)
|
||||
```
|
||||
|
||||
Здесь мы создаём маршрут /check и добавляем к нему аннотацию `@api.doc`, которая автоматически включит описание этого маршрута в Swagger-документацию.
|
||||
|
||||
После этого запускаем наше приложение командой `python имя_файла.py`.
|
||||
|
||||
Чтобы увидеть документацию, нужно открыть приложение в браузере: его адрес будет в командной строке при запуске. В браузере увидим интерфейс Swagger и метод, который он нашёл в нашем коде. Там же можно просмотреть и протестировать API:
|
||||
|
||||
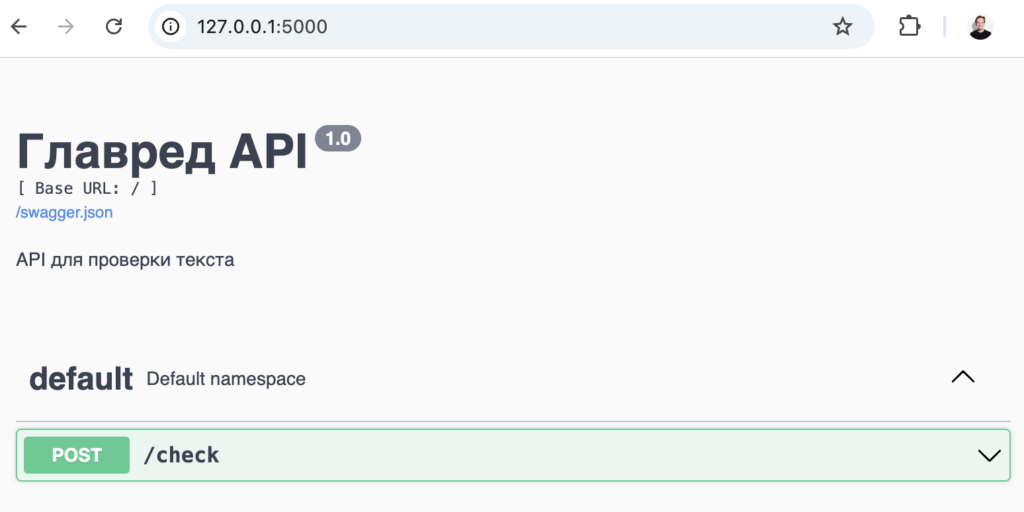
|
||||
|
||||
Что такое Swagger и как он облегчает работу с API
|
||||
|
||||
## Преимущества и недостатки Swagger
|
||||
|
||||
Swagger хорошо подходит для создания понятной документации к API, особенно если нужно, чтобы ею могли пользоваться не только разработчики, но и менеджеры или клиенты.
|
||||
|
||||
**Преимущества Swagger**
|
||||
|
||||
- Удобный интерфейс: Swagger UI показывает API в структурированном виде — сразу понятно, что к чему.
|
||||
- Понятность: Swagger-документация понятна не только разработчикам, но и не техническим специалистам.
|
||||
- Интерактивность: с помощью Swagger UI можно тестировать API прямо в документации, отправляя запросы и проверяя ответы.
|
||||
- Просто редактировать: документация создаётся в форматах JSON и YAML, которые удобно читать и редактировать.
|
||||
- Автоматизация процессов: Swagger помогает автоматизировать документирование, тестирование и поддержку API.
|
||||
|
||||
**Недостатки Swagger**
|
||||
|
||||
- Ограничения для сложных API: Swagger лучше всего подходит для простых REST API, но может ограничивать гибкость для более сложных сценариев.
|
||||
- Не подходит для других архитектур: Swagger предназначен для REST API и не работает с gRPC или GraphQL.
|
||||
- Громоздкие файлы: для больших API файлы спецификации могут быть громоздкими и трудными в поддержке.
|
||||
- Порог входа: требует времени на изучение.
|
||||
- Ограничения OpenAPI: ограничен функциями, поддерживаемыми стандартом OpenAPI, что не всегда удобно для специфичных требований.
|
||||
|
||||
## Аналоги Swagger
|
||||
|
||||
Если Swagger кажется сложным, или наоборот, его функций недостаточно, то можно рассмотреть другие подобные инструменты.
|
||||
@@ -0,0 +1,230 @@
|
||||
---
|
||||
title: "Шпаргалка по Markdown - Самые полезные структуры и форматирование"
|
||||
source: "https://www.glukhov.org/ru/post/2024/03/markdown-cheatsheet/"
|
||||
author:
|
||||
- "[[Рост Глухов | Персональный сайт и технический блог]]"
|
||||
published: 2023-03-20
|
||||
created: 2025-08-23
|
||||
description: "Шпаргалка по Markdown - Самые полезные структуры и форматирование"
|
||||
tags:
|
||||
- "clippings"
|
||||
---
|
||||
Язык разметки [Markdown](https://www.glukhov.org/ru/post/2024/03/markdown-cheatsheet/ "Справочник по Markdown") используется в Википедии и [Hugo](https://www.glukhov.org/ru/post/2024/06/deploy-hugo-site-to-aws/ "Развертывание сайта Hugo на AWS S3"). Он поддерживает заголовки, списки, изменения стиля шрифта, изображения, цитаты кода и таблицы. Здесь я сохраняю краткое резюме форматирования Markdown.
|
||||
|
||||
 Это изображение выше создано [Flux - AI для генерации изображений по тексту](https://www.glukhov.org/ru/post/2024/09/flux-text-to-image/ "Flux 1 dev - AI для генерации изображений по тексту").
|
||||
|
||||
Markdown — это [легковесный](https://www.glukhov.org/ru/ "сайт, сгенерированный с помощью Hugo, очень легковесный") язык разметки, который можно использовать для добавления элементов форматирования в текстовые документы с обычным текстом. Это руководство предоставляет всесторонний обзор наиболее часто используемого [синтаксиса Markdown](https://www.glukhov.org/ru/post/2024/03/markdown-cheatsheet/ "Справочник по Markdown"), помогая вам создавать хорошо структурированные и визуально привлекательные документы.
|
||||
|
||||
## Заголовки
|
||||
|
||||
Заголовки в Markdown создаются с помощью символа решетки (#). Количество решеток перед текстом заголовка указывает уровень заголовка.
|
||||
|
||||
```md
|
||||
# H1
|
||||
## H2
|
||||
### H3
|
||||
#### H4
|
||||
##### H5
|
||||
###### H6
|
||||
```
|
||||
|
||||
## Выделение
|
||||
|
||||
Markdown предоставляет несколько способов выделения текста. Вы можете использовать звездочки (\*) или подчеркивания (\_) для курсива и двойные звездочки (\*\*) или двойные подчеркивания (\_\_) для жирного.
|
||||
|
||||
Курсив
|
||||
|
||||
```md
|
||||
*Курсив* или _курсив_
|
||||
```
|
||||
|
||||
Жирный
|
||||
|
||||
```md
|
||||
**Жирный** или __жирный__
|
||||
```
|
||||
|
||||
Жирный и курсив
|
||||
|
||||
```md
|
||||
***Жирный и курсив*** или ___жирный и курсив___
|
||||
```
|
||||
|
||||
## Списки
|
||||
|
||||
Markdown поддерживает как нумерованные, так и ненумерованные списки.
|
||||
|
||||
Ненумерованный список
|
||||
|
||||
```md
|
||||
- Пункт 1
|
||||
- Пункт 2
|
||||
- Подпункт 1
|
||||
- Подпункт 2
|
||||
```
|
||||
|
||||
Нумерованный список
|
||||
|
||||
```md
|
||||
1. Первый пункт
|
||||
2. Второй пункт
|
||||
1. Подпункт 1
|
||||
2. Подпункт 2
|
||||
```
|
||||
|
||||
## Ссылки
|
||||
|
||||
Ссылки создаются путем заключения текста ссылки в квадратные скобки (\[\]) и затем заключения URL в круглые скобки (()).
|
||||
|
||||
```md
|
||||
[Текст ссылки](URL)
|
||||
```
|
||||
|
||||
Пример
|
||||
|
||||
```md
|
||||
Посетите [Руководство по Markdown](https://www.markdownguide.org/) для получения дополнительной информации.
|
||||
```
|
||||
|
||||
## Изображения
|
||||
|
||||
Изображения добавляются с помощью восклицательного знака (!), за которым следует альтернативный текст в квадратных скобках и URL изображения в круглых скобках.
|
||||
|
||||
```md
|
||||

|
||||
```
|
||||
|
||||
Пример
|
||||
|
||||
```md
|
||||

|
||||
```
|
||||
|
||||
## Блочные цитаты
|
||||
|
||||
Блочные цитаты создаются с помощью символа больше чем (>).
|
||||
|
||||
```md
|
||||
> Это блочная цитата.
|
||||
```
|
||||
|
||||
Вложенные блочные цитаты
|
||||
|
||||
```md
|
||||
> Это первый уровень цитирования.
|
||||
>> Это вложенная блочная цитата.
|
||||
```
|
||||
|
||||
## Встроенный код и блоки кода
|
||||
|
||||
Встроенный код можно добавить, заключив его в обратные кавычки (\`). Для блоков кода используйте тройные обратные кавычки (\`\`\`) до и после кода.
|
||||
|
||||
Встроенный код
|
||||
|
||||
```md
|
||||
Используйте \`printf()\` для вывода текста в C.
|
||||
```
|
||||
|
||||
Блоки кода
|
||||
|
||||
```md
|
||||
\`\`\`python
|
||||
def hello_world():
|
||||
print("Hello, World!")
|
||||
\`\`\`
|
||||
```
|
||||
|
||||
Больше о блоках кода в Markdown — см. отдельный пост: [Использование блоков кода Markdown](https://www.glukhov.org/ru/post/2025/07/markdown-codeblocks/ "Блоки кода Markdown - подробное описание")
|
||||
|
||||
## Горизонтальные правила
|
||||
|
||||
Горизонтальные правила создаются с помощью трех или более тире (—), звездочек (\*\*\*) или подчеркиваний (\_\_).
|
||||
|
||||
```markdown
|
||||
---
|
||||
```
|
||||
|
||||
## Таблицы
|
||||
|
||||
Таблицы в Markdown создаются с помощью вертикальных линий (|) и тире (-).
|
||||
|
||||
```md
|
||||
Пример
|
||||
| Заголовок 1 | Заголовок 2 |
|
||||
|-------------|-------------|
|
||||
| Ячейка 1 | Ячейка 2 |
|
||||
| Ячейка 3 | Ячейка 4 |
|
||||
```
|
||||
|
||||
## Списки задач
|
||||
|
||||
Списки задач — это специальный тип списков, который позволяет создавать флажки.
|
||||
|
||||
```md
|
||||
Пример
|
||||
- [x] Выполненная задача
|
||||
- [ ] Незавершенная задача
|
||||
```
|
||||
|
||||
## Зачеркнутый текст
|
||||
|
||||
Зачеркнутый текст создается с помощью двойных тильд (~~).
|
||||
|
||||
```md
|
||||
~~Это зачеркнутый текст.~~
|
||||
```
|
||||
|
||||
## Выделение
|
||||
|
||||
Выделение текста не поддерживается нативно в Markdown, но некоторые рендереры поддерживают его с использованием синтаксиса ==.
|
||||
|
||||
Пример
|
||||
|
||||
```md
|
||||
==Это выделенный текст.==
|
||||
```
|
||||
|
||||
## Подстрочные и надстрочные индексы
|
||||
|
||||
Подстрочные индексы создаются с помощью символа caret (^) перед текстом, а надстрочные индексы — с помощью символа тильда (~) перед текстом.
|
||||
|
||||
Пример
|
||||
|
||||
```md
|
||||
H 2 O — это вода.
|
||||
E = mc^2
|
||||
```
|
||||
|
||||
## Математические формулы
|
||||
|
||||
Математические формулы можно добавлять с использованием синтаксиса LaTeX внутри знаков доллара ($).
|
||||
|
||||
Пример
|
||||
|
||||
```md
|
||||
$$ E = mc^2 $$
|
||||
```
|
||||
|
||||
## Экранирование символов
|
||||
|
||||
Для экранирования специальных символов используйте обратную косую черту ().
|
||||
|
||||
Пример
|
||||
|
||||
```md
|
||||
\*Курсив\* или \_курсив\_
|
||||
```
|
||||
|
||||
Это всесторонний справочник, который охватывает основной синтаксис Markdown, необходимый для создания хорошо отформатированных документов. Для более сложных функций и настраиваемых параметров обратитесь к документации конкретного рендерера или дополнительным ресурсам.
|
||||
|
||||
## Полезные ссылки
|
||||
|
||||
- [Использование блоков кода Markdown](https://www.glukhov.org/ru/post/2025/07/markdown-codeblocks/ "Блоки кода Markdown - подробное описание")
|
||||
- [Справочник по Hugo](https://www.glukhov.org/ru/post/2022/hugo-cheatsheet/ "Справочник по Hugo - список и описание полезных команд статического генератора сайтов Hugo")
|
||||
- [Отправка формы Google в сайте Hugo](https://www.glukhov.org/ru/post/2025/04/submit-form-in-hugo-website/ "Инструкции по отправке формы в сайте Hugo с использованием Google Forms")
|
||||
- [Использование Gitea Actions для развертывания сайта Hugo на AWS S3](https://www.glukhov.org/ru/post/2025/06/using-gitea-actions-deploy-hugo-to-s3/ "Использование Gitea Actions для развертывания сайта Hugo на AWS S3")
|
||||
- [Справочник по Bash](https://www.glukhov.org/ru/post/2024/04/bash-cheat-sheet/)
|
||||
- [Справочник по LaTeX](https://www.glukhov.org/ru/post/2024/12/latex-cheat-sheet/ "Справочник по LaTeX - добавление таблиц, диаграмм, изображений, оглавления и других полезных примеров")
|
||||
- [Справочник по Ollama](https://www.glukhov.org/ru/post/2024/12/ollama-cheatsheet/ "Справочник по Ollama")
|
||||
- [Справочник по Docker](https://www.glukhov.org/ru/post/2024/10/docker-cheatsheet/ "список и описание наиболее частых и полезных команд Docker - справочник по Docker")
|
||||
- [Самые популярные темы для Hugo](https://www.glukhov.org/ru/post/2025/05/top-hugo-themes/ "Лучшие темы для Hugo")
|
||||
Reference in New Issue
Block a user